마스코트가 배경을 먹었습니다: 학습을 의심했는데 범인은 학습 데이터였습니다
브랜드 마스코트를 여러 영상에 반복 등장시키려고 캐릭터 어댑터를 학습했는데 요청한 장면이 자꾸 같은 배경으로 뭉개진다면, 학습이라는 방법을 의심하기 전에 학습 클립의 배경부터 보십시오. 저희는 그 순서를 반대로 밟았다가 방법 탓을 했고, 확인해 보니 원인은 저희가 만든 데이터에 있었습니다.
먼저 결과물입니다
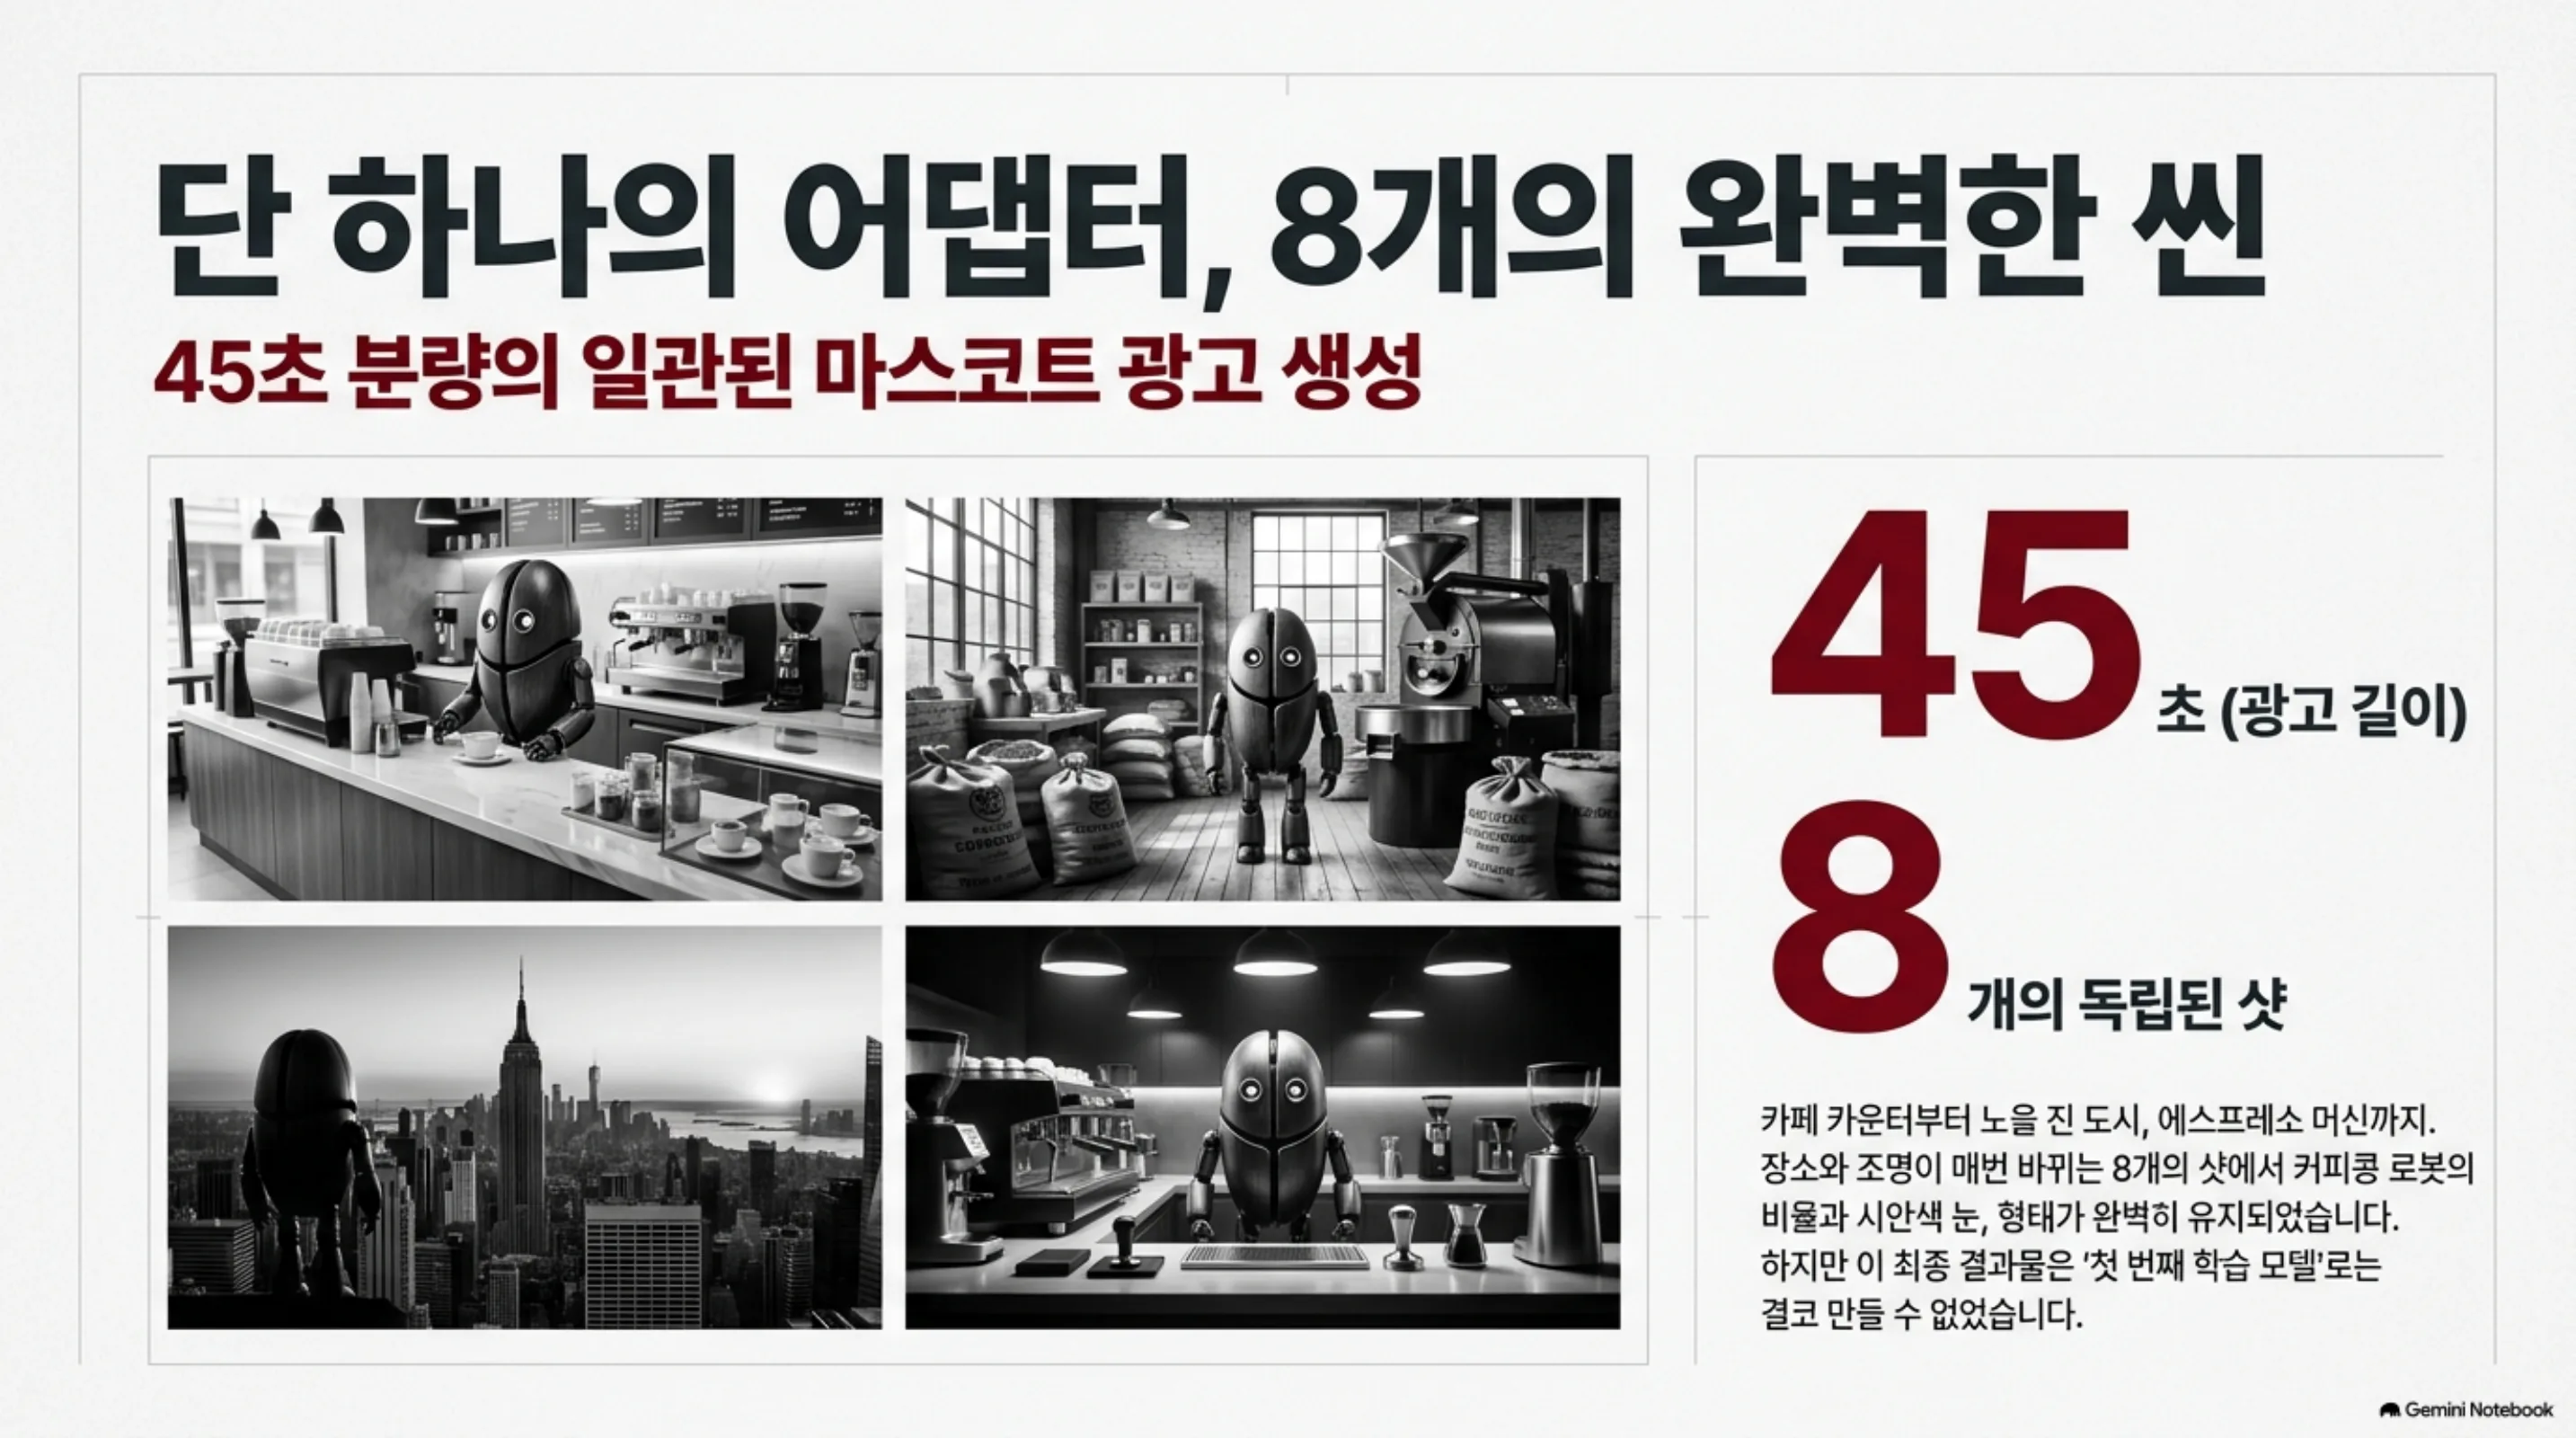
가상 브랜드 NUBO COFFEE의 마스코트 광고 45초입니다. 학습된 어댑터 하나로 뽑았고, 카페 카운터에서 시작해 사무실 책상, 로스터리 원두 자루, 노을 진 도시, 주방, 컵 컨베이어, 에스프레소 머신까지 이어집니다.
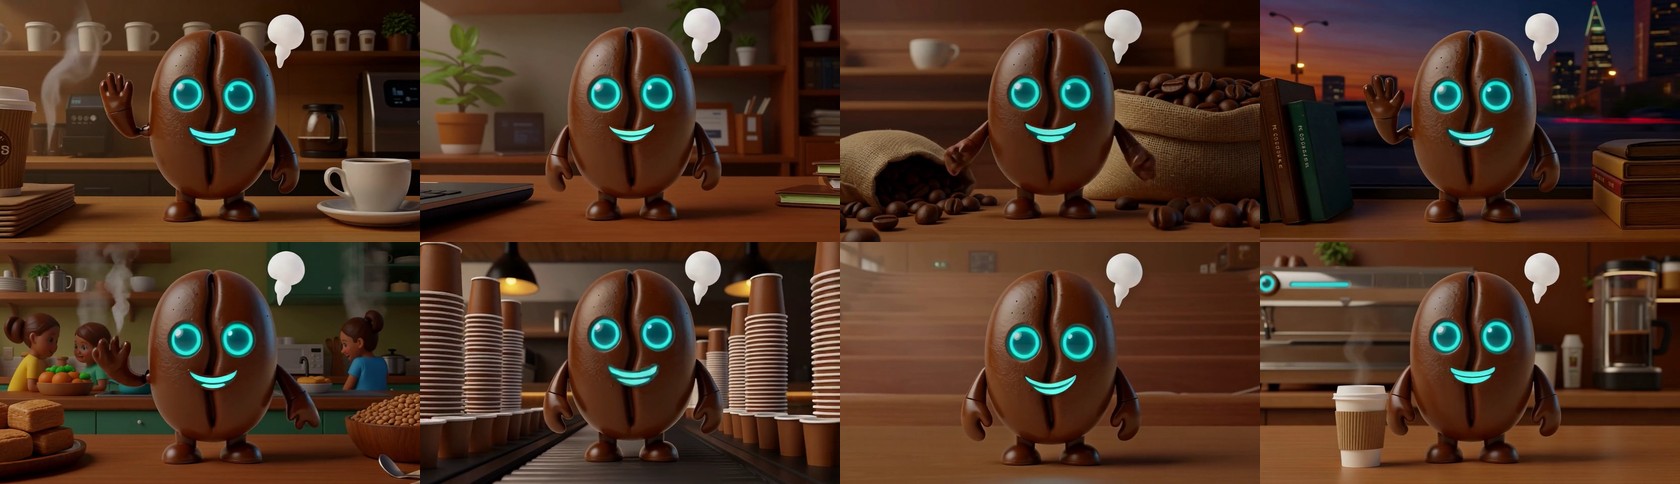 여덟 샷 전부입니다. 장소와 조명이 매번 바뀌는데 커피콩 로봇의 비율과 시안색 눈, 손발 형태가 유지됩니다. 일곱 번째 샷은 배경이 밋밋하게 나왔는데 그대로 실었습니다.
마스코트는 완전 합성 캐릭터이고, 아래 여섯 장의 스틸이 모든 방법에 동일하게 주어진 유일한 입력입니다.
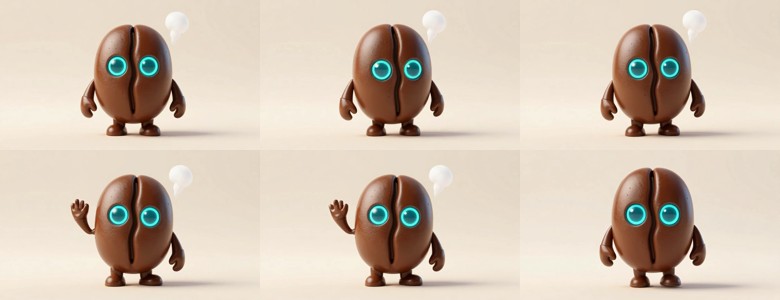 이 여섯 장이 레퍼런스로 들어갑니다.
그런데 첫 번째 광고는 이 어댑터로 만들지 못했습니다
원래 가설은 이랬습니다. 얼굴이 아닌 대상이라면 얼굴 전용 사전지식을 쓰는 zero-shot 방식이 힘을 못 쓸 테니 학습이 이길 것이다. 그래서 커피콩 로봇 클립 열두 개를 만들어 400스텝 학습하고, 같은 여덟 개 프롬프트로 네 가지 방법을 나란히 돌렸습니다.
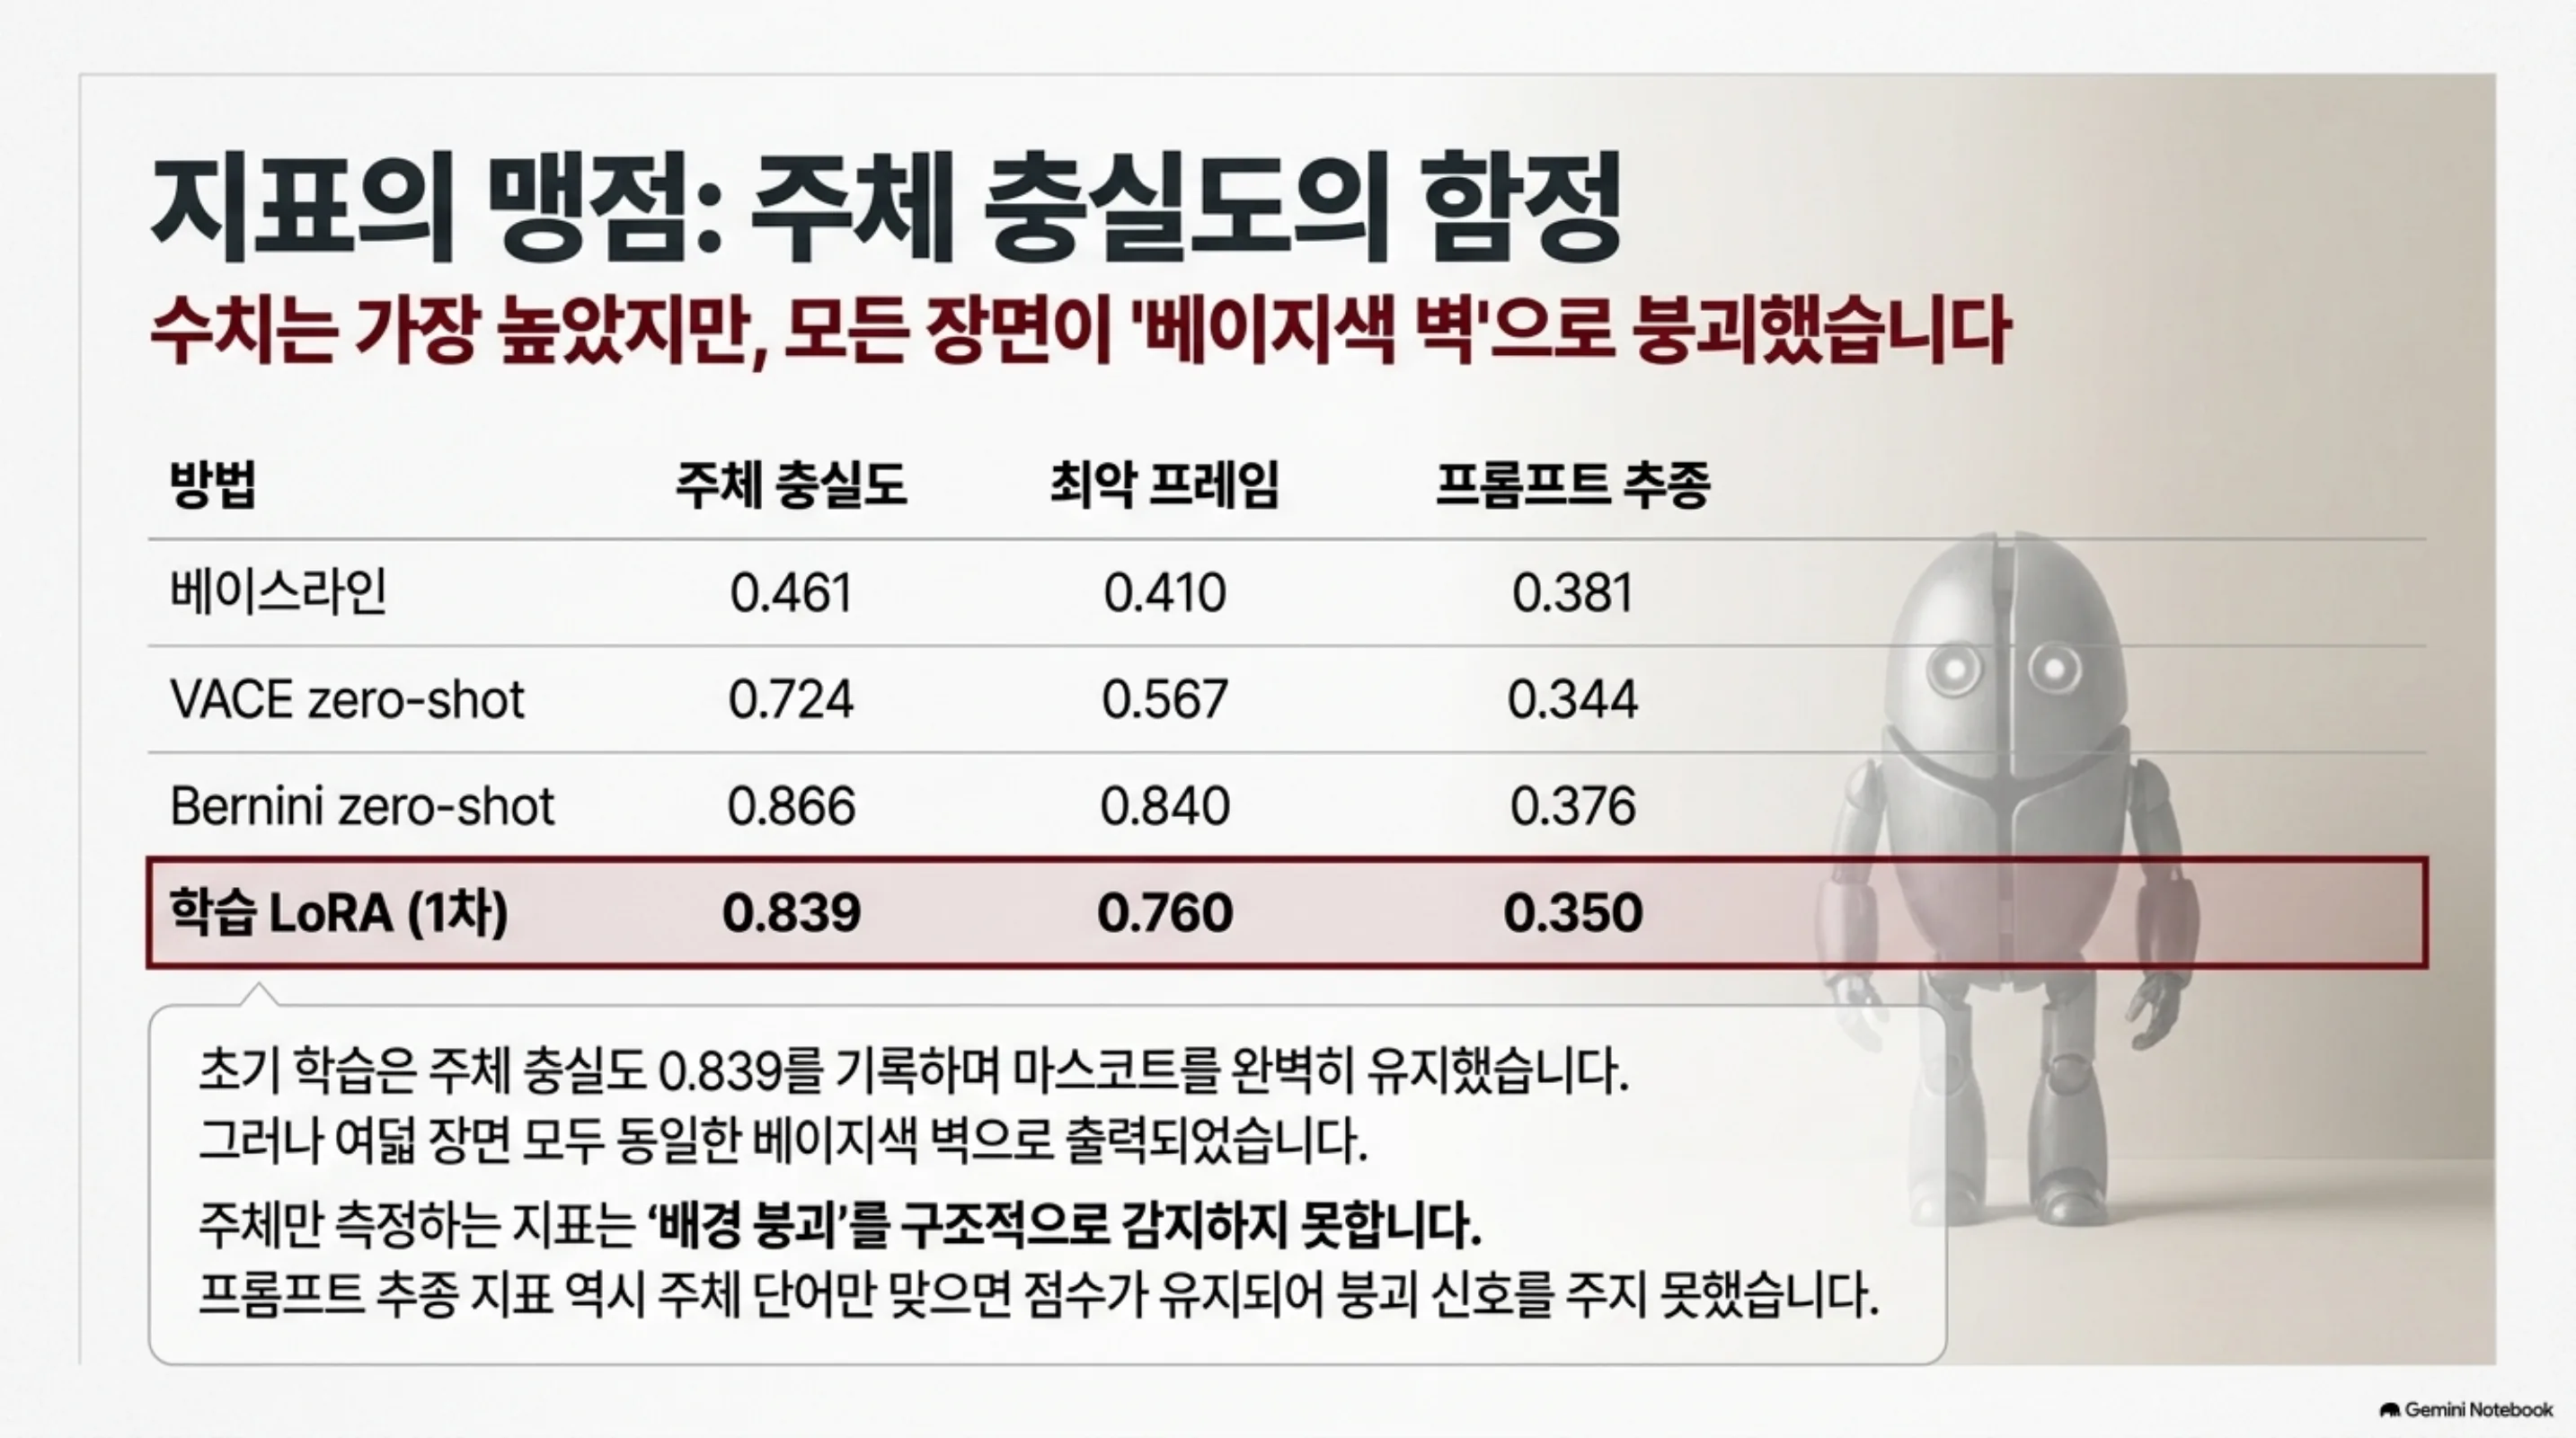
결과를 표로 보면 학습은 나쁘지 않았습니다.
| 방법 | 주체 충실도 | 최악 프레임 | 프롬프트 추종 |
|---|---|---|---|
| 베이스라인 (조건 없음) | 0.461 | 0.410 | 0.381 |
| VACE zero-shot | 0.724 | 0.567 | 0.344 |
| Bernini zero-shot | 0.866 | 0.840 | 0.376 |
| 학습 LoRA | 0.839 | 0.760 | 0.350 |
그런데 조립해 보니 이런 영상이 나왔습니다.
마스코트는 완벽하게 일관되는데 여덟 장면이 사실상 한 장면입니다. 카페 카운터도, 로스터리 원두 자루도, 스튜디오 조명도 전부 같은 베이지색 벽이 됐습니다. 광고로 쓸 수 없어서 그때는 zero-shot으로 최종본을 만들었습니다.
주체 충실도 0.839는 마스코트를 잘 지켰다는 뜻이지 장면을 지켰다는 뜻이 아닙니다. 이 지표는 주체만 재기 때문에 배경이 무너지는 것을 구조적으로 볼 수 없습니다. 프롬프트 추종 지표도 0.350 대 0.344로 거의 신호를 주지 않았는데, 짧은 프롬프트에서는 주체 단어만 맞아도 점수가 유지되기 때문입니다.
범인은 학습 데이터였습니다
의심스러운 지점이 하나 있었습니다.
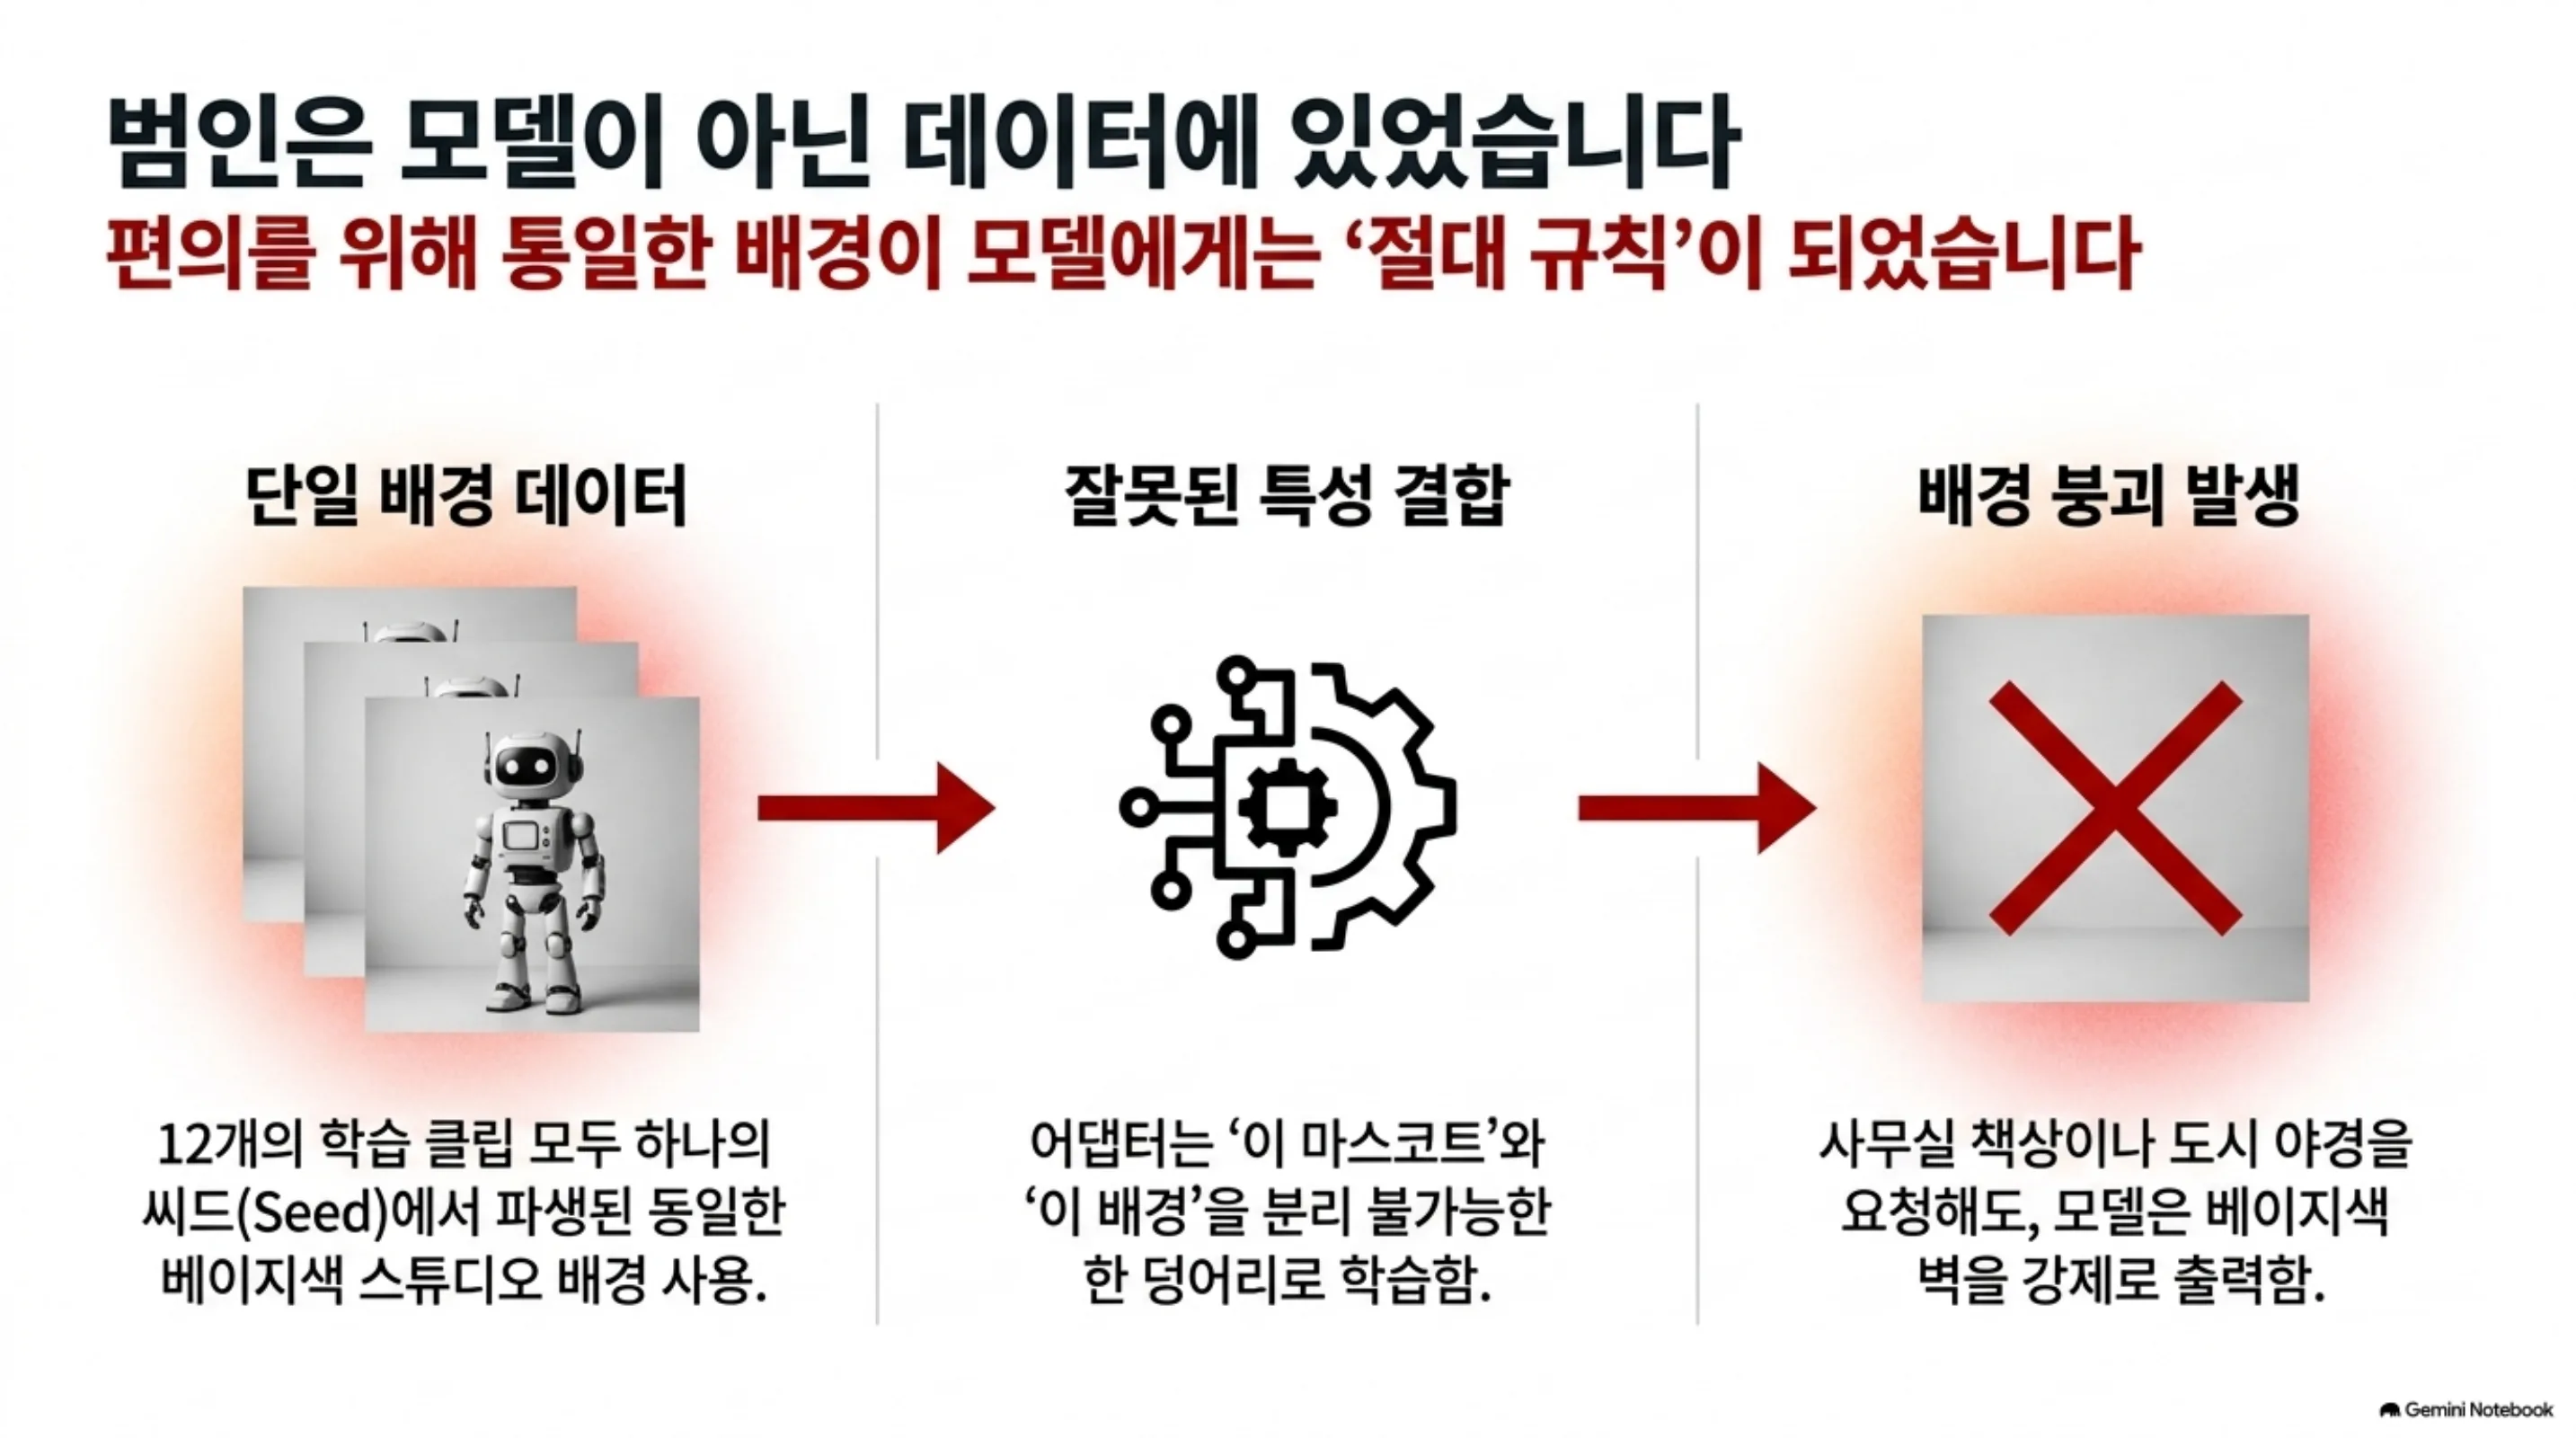
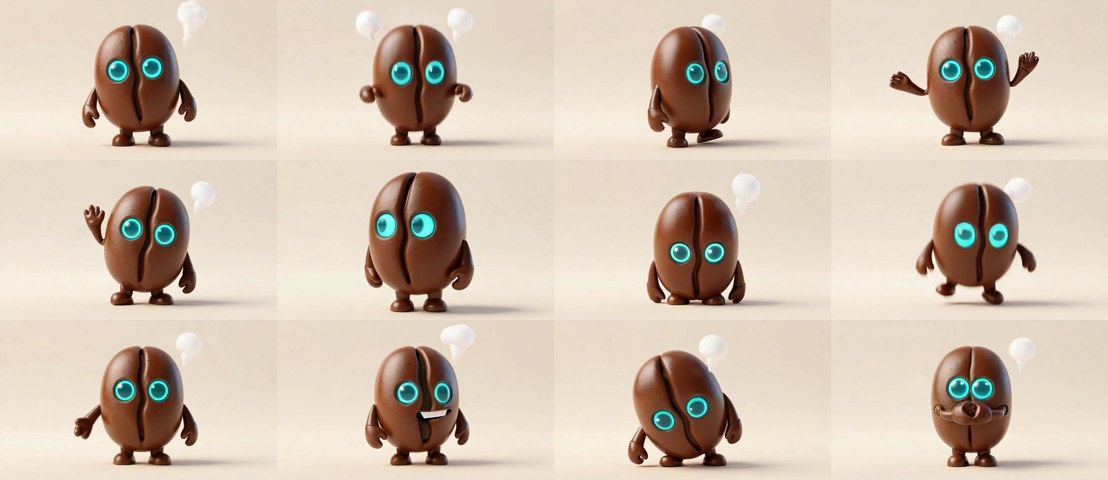 첫 번째 학습에 쓴 클립 전부입니다. 열두 개가 전부 같은 베이지색 스튜디오 배경입니다.
하나의 씨드 클립에서 파생시켰으니 당연한 결과였는데, 어댑터 입장에서는 “이 마스코트”와 “이 배경”이 분리되지 않는 한 덩어리였을 수 있습니다.
그래서 같은 마스코트를 공원 벤치, 도서관 서가, 해질녘 백사장, 눈 내리는 밤거리, 지하철 승강장, 온실, 빵집 진열대처럼 열두 곳에서 새로 찍고 다시 학습했습니다. 레퍼런스 이미지는 인덱스까지 맞춰 동일하게 두고 rank와 학습률과 스텝 수와 시드까지 전부 고정했습니다. 바뀐 것은 배경뿐입니다.
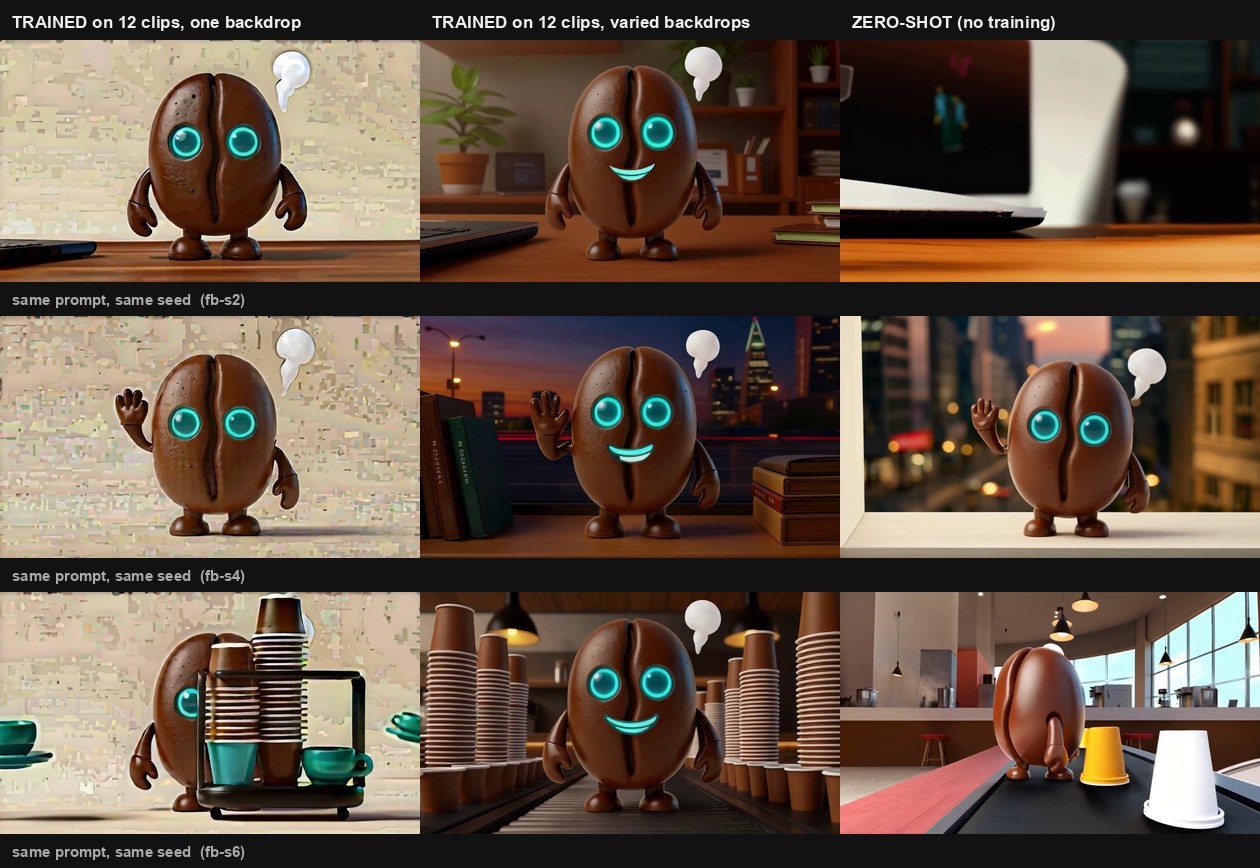 세 줄 모두 같은 프롬프트와 같은 시드입니다. 왼쪽이 첫 번째 어댑터, 가운데가 배경만 바꿔 다시 학습한 어댑터, 오른쪽이 학습 없이 레퍼런스만 준 결과입니다.
왼쪽 열에서 사무실 책상도 도시 야경도 컵 컨베이어도 전부 같은 벽 텍스처인데, 가운데 열은 같은 학습 방식인데도 장면이 살아 있습니다. 두 열의 차이는 학습에 쓴 열두 클립을 어디서 찍었느냐 하나뿐입니다.
오른쪽 열도 눈여겨봐 주십시오. 장면은 잘 나오는데 첫 줄에서는 마스코트가 아예 사라졌습니다. 노트북과 책상만 있습니다. 세 번째 줄에서는 형체는 있지만 눈이 없습니다.
숫자로 확인했습니다
배경 붕괴를 재려면 지표가 하나 필요했습니다. 붕괴의 서명은 서로 다른 프롬프트를 준 클립들이 서로 닮는 것이므로, 레퍼런스와의 거리가 아니라 클립끼리의 유사도를 쟀습니다. 주체가 모든 방식에서 같으니 프레임 중앙을 도려내고 테두리만 비교했습니다. 이 지표가 실제로 붕괴를 가르는지부터 확인했는데, 눈으로 붕괴가 확인된 어댑터가 0.906으로 가장 높고 아무 조건도 주지 않은 베이스라인이 0.714로 가장 낮게 나왔습니다.
| 배경 붕괴 | 주체 충실도 | 최악 프레임 | |
|---|---|---|---|
| 배경 고정 학습 | 0.906 | 0.839 | 0.760 |
| 배경 다양화 학습 | 0.791 | 0.843 | 0.819 |
| zero-shot | 0.792 | 0.724 | 0.568 |
새 어댑터는 0.791로 zero-shot의 0.792와 같은 자리에 왔습니다. 중요한 것은 마스코트를 잃지 않았다는 점입니다. 주체 충실도 변화는 0.004로 통계적으로 의미가 없습니다(p=0.67). 배경을 되찾느라 캐릭터를 내준 교환이 아니라, 배경이 캐릭터의 일부라고 가르치던 것을 그만둔 것뿐입니다.
두 번째 신호도 함께 정상으로 돌아왔습니다. 붕괴한 어댑터는 클립 쌍끼리의 유사도 편차가 0.022로 유독 작았습니다. 모든 쌍이 고르게 닮았다는 뜻이고, 하나의 배경으로 수렴했다는 이야기입니다. 새 어댑터는 0.060으로 다른 방식들과 같은 범위에 들어왔습니다.
배경 다양성을 맞췄을 때의 재비교
배경 다양성이 같아진 상태에서 다시 비교하면 오히려 학습 쪽이 유리한 자리가 보입니다. 클립 안에서 주체가 가장 무너지는 지점을 보면 학습본이 0.819, zero-shot이 0.568로 이 차이는 통계적으로 유의합니다(p=0.044). 위 그림 첫 줄에서 zero-shot이 마스코트를 통째로 놓친 것이 이 숫자의 정체입니다. 다만 평균 충실도 차이(0.843 대 0.724)는 여덟 개 클립에서는 유의하지 않으므로(p=0.16), 지금 말할 수 있는 것은 평균이 아니라 최악의 순간에 대한 이야기입니다.
남는 교훈
지표가 못 보는 축이 있으면 그 축에서 실패한 모델이 1위로 올라옵니다. 주체 충실도만으로 승자를 뽑았다면 저희는 여덟 장면을 모두 잃은 어댑터를 골랐을 것입니다. 배경과 장면 구성을 따로 재는 축을 붙이고 나서야 순위가 제대로 보였습니다.
그리고 방법의 한계처럼 보이는 것이 데이터의 성질인 경우가 있습니다. 열두 클립을 한 장소에서 찍은 것은 편의였지 설계가 아니었는데, 그 편의가 모델에게는 “이 캐릭터는 베이지색 벽 앞에 산다”는 규칙으로 전달됐습니다. 소규모 학습셋일수록 촬영 조건의 공통점이 그대로 캐릭터의 일부가 됩니다.
ThakiCloud 관점
마스코트 클립 생성부터 열두 클립 학습, 네 방법의 동일 조건 비교, 배경을 바꾼 재학습과 재측정, 45초 조립까지 전부 사내 GPU 안에서 닫혔습니다. 브랜드 자산인 캐릭터가 외부 API로 나간 적이 없습니다. 학습이 필요한 국면은 Maxis가, 생성과 서빙은 Metis가 맡습니다.
이번 일에서 실제로 값어치를 한 것은 어느 방법이 이겼느냐가 아니라, 틀린 결론을 자기 데이터로 다시 재서 뒤집을 수 있었다는 점입니다. 방법을 바꾸는 것이 아니라 데이터를 바꿔야 하는 문제였다는 것도, 재보지 않았다면 알 수 없었습니다.
이 글의 수치는 시뮬레이션이 아니라 사내 GPU에서 측정한 값입니다.
참고 자료
- VACE: All-in-One Video Creation and Editing: 비교에 쓴 zero-shot 레퍼런스 조건 방식
- Wan2.2: 베이스로 쓴 오픈 가중치 영상 모델
- LoRA: Low-Rank Adaptation of Large Language Models: 학습 어댑터의 원 논문
- 이전 글: 레퍼런스 조건 영상 LoRA를 사내 GPU로 재현하기: LoRA 학습 레시피와 동일 조건 비교의 기준
- 마스코트 눈이 외계인 같다면 색이 아니라 캐치라이트 문제입니다: 같은 커피콩 마스코트 시리즈의 후속(눈 리디자인과 레퍼런스 표정 다양화)