Google Gemini 4 Carbon, 사이버보안·롱호라이즌 SOTA에 intro 가격 반값
왜 읽어야 하나
에이전트 워크플로의 모델 비용을 설계하거나, frontier 모델 API와 오픈웨이트 모델을 함께 쓰는 플랫폼을 운영한다면 이 글이 필요합니다. 핵심 결론을 먼저 적습니다. Google이 10월 28일 공개한 Gemini 4 Carbon은 ‘사이버보안과 장기간(long-horizon) 작업’을 표방한 frontier 모델이고, intro 기간 $2/$10(1M 토큰당)이라는 낮은 가격에서 그 성향이 에이전트 실행 비용에 어떻게 들어가는지 계산해 볼 수 있는 시점입니다. 출시 첫 주에는 일반 개발자보다 사이버 방어자 subset과 신뢰 파트너가 먼저 쓰므로, 지금 필요한 것은 성능 숫자보다 ‘어떤 워크로드에 이 가격대가 적용되는가’를 보는 것입니다.
개요
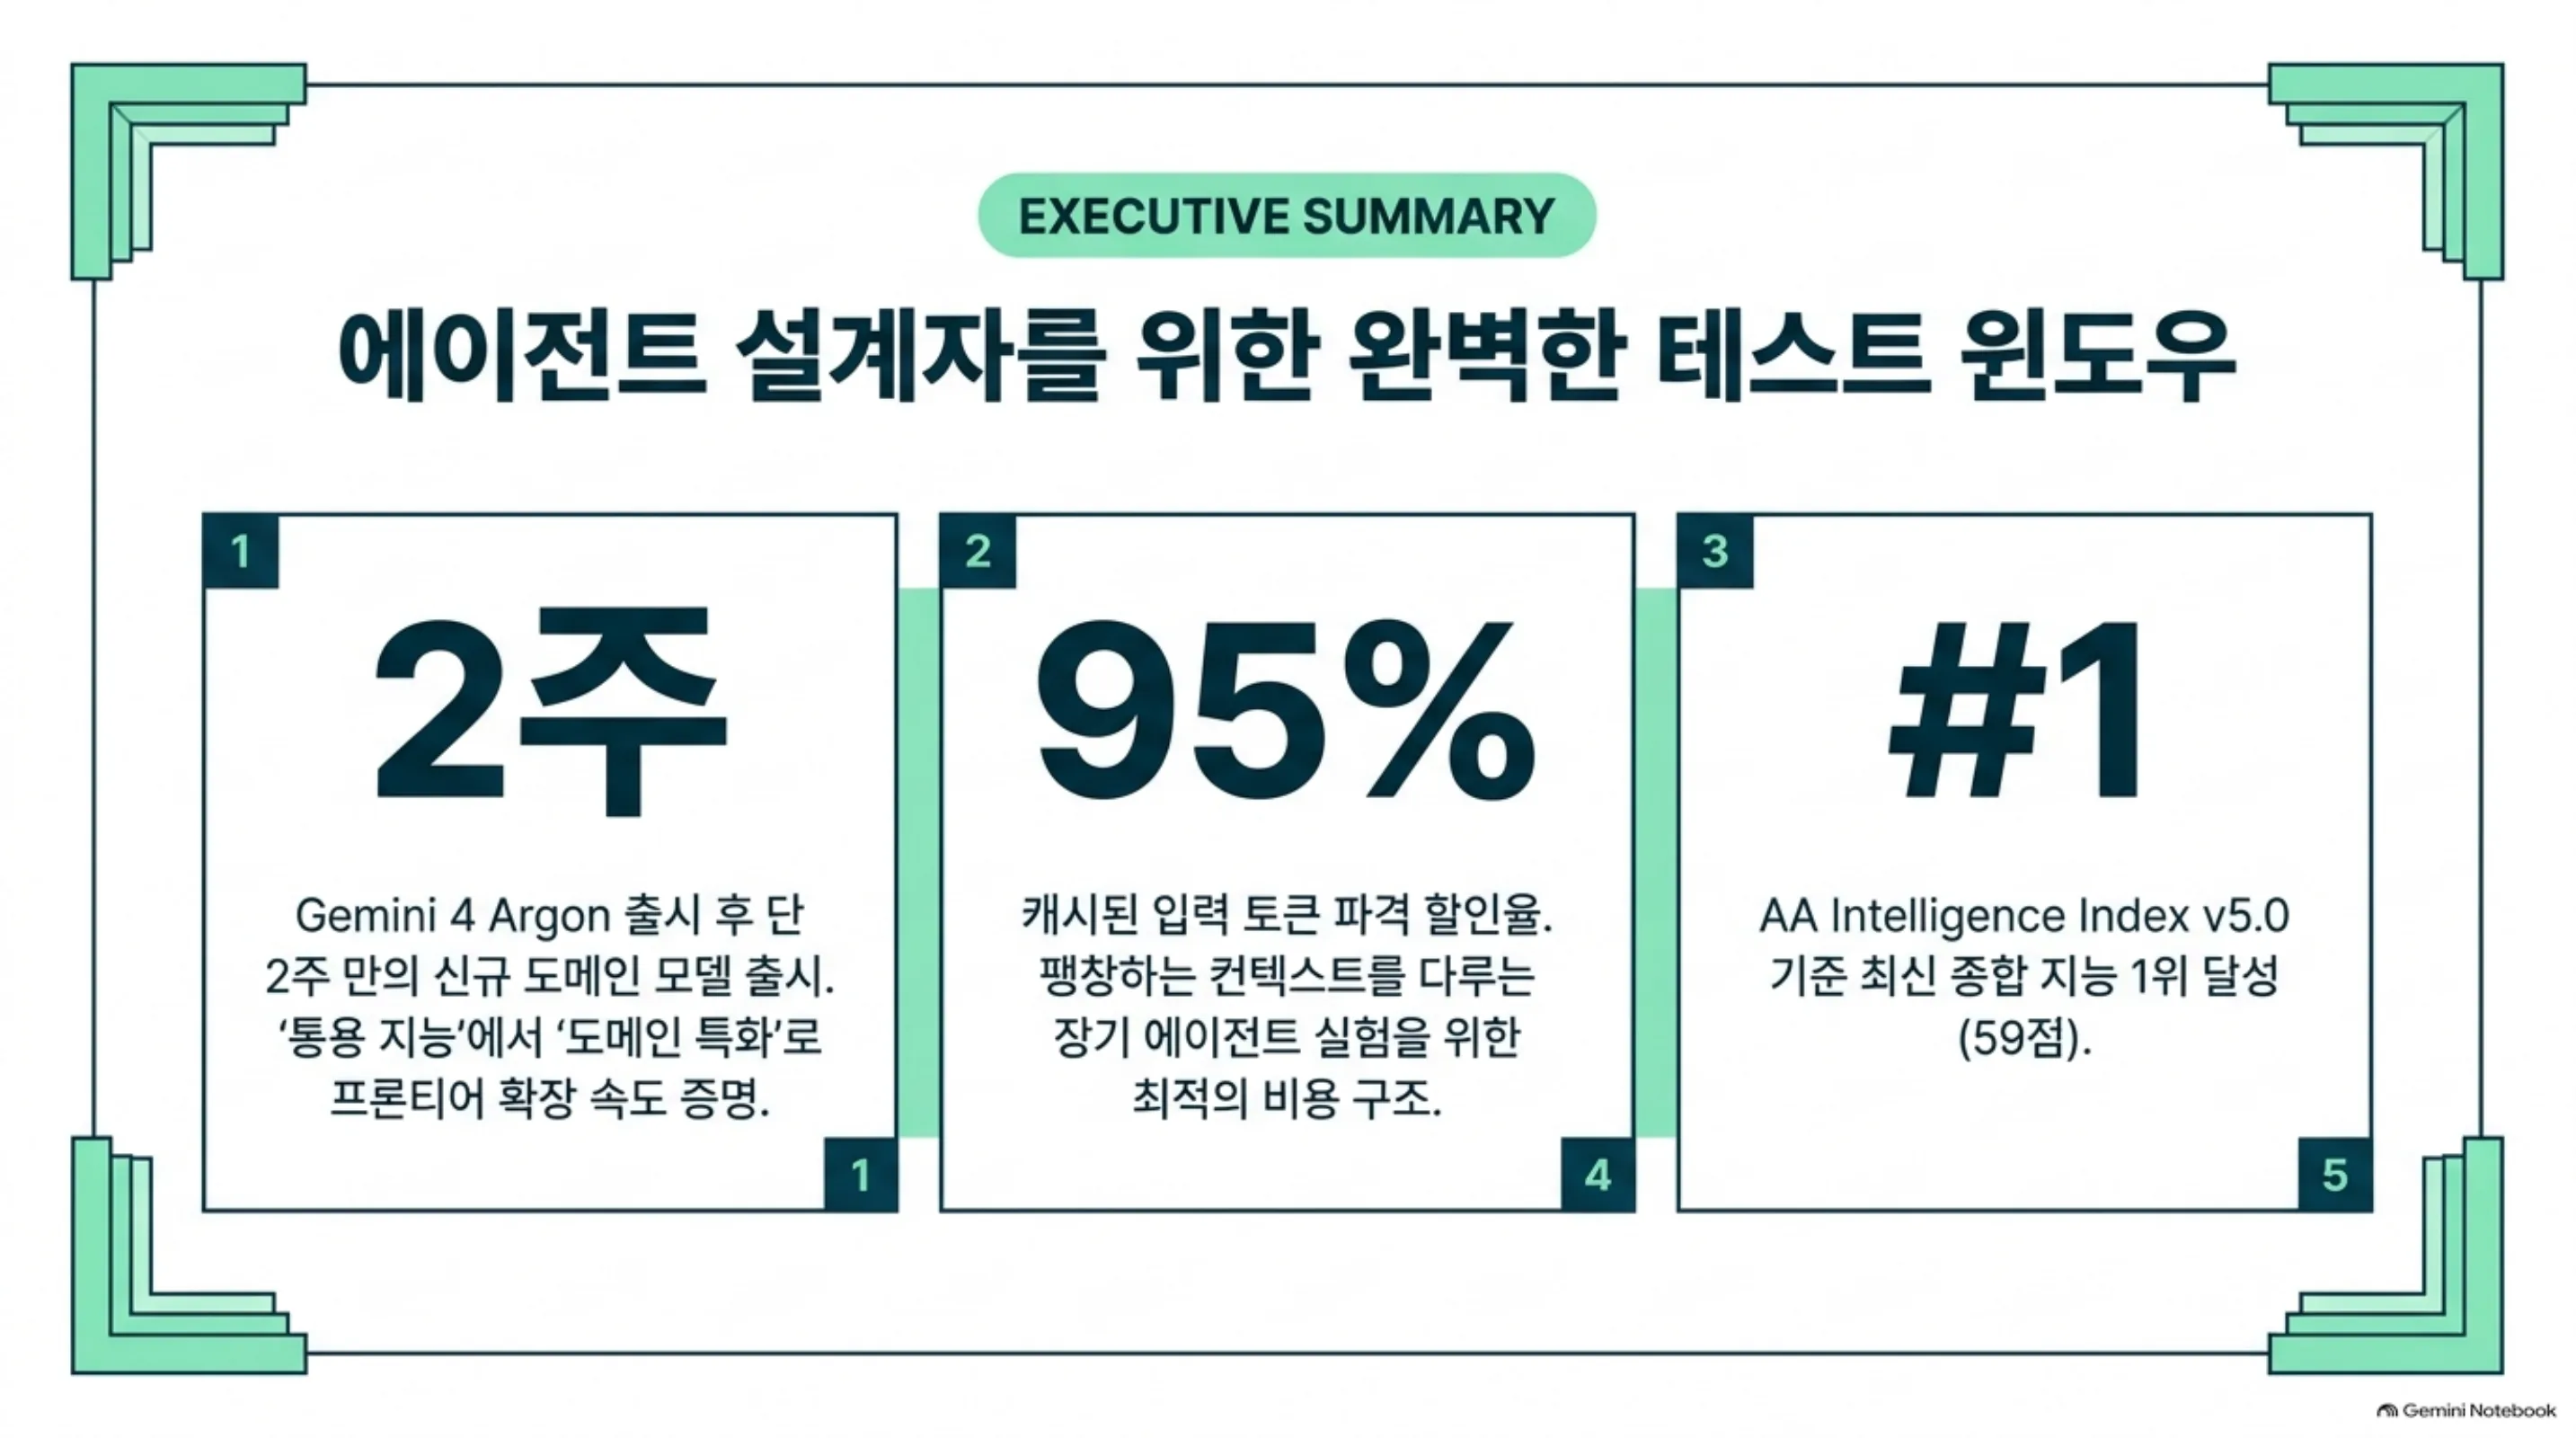
Google은 2026년 10월 28일 공식 블로그(The Keyword)에서 Gemini 4 Carbon을 ‘our next frontier model’, ‘사이버보안과 long-horizon 능력에서 state-of-the-art인 가장 강력한 모델’이라고 발표했습니다. 전 모델 Gemini 4 Argon이 공개된 지 2주 만입니다. Google은 Carbon을 frontier를 밀어내는 속도(‘the pace at which we’re pushing the frontier forward’)의 증거로 제시했습니다.
배경을 하나 덧붙입니다. Argon은 10월 초에 공개된 Gemini 4군의 첫 모델로, ‘가장 어려운 문제를 푸는’ 포지션을 갖고 있습니다. Carbon은 그 2주 뒤에 나왔고, Google은 이 간격을 frontier를 밀어내는 속도의 증거로 제시했습니다. 두 번째 모델에서 사이버보안과 long-horizon이라는 특정 축을 앞세운다는 것은, Gemini 4군이 ‘통용 지능’ 한 축이 아니라 도메인 축별로 frontier를 확장하는 구조로 움직이고 있다는 신호로 읽힙니다. 한편 Artificial Analysis Intelligence Index는 독립 벤치마크 운영사가 여러 평가 세트를 모아 내놓는 종합 지능 인덱스입니다. v5.0이 ‘최근 업데이트된’ 버전이라는 점을 Google이 함께 강조한 것은, 최신 인덱스 기준의 1위를 의미한다는 것입니다.
이번 발표의 축은 셋입니다. 첫째, Artificial Analysis Intelligence Index v5.0(최근 업데이트된 버전)에서 59점으로 1위. 둘째, 사이버보안 특화 벤치마크 3종(SEC-bench Pro 88.2%, ExploitGym 54.8%, CWE-bench 71.0%)과 WebDev Arena(1768 elo, +89) 상승. 셋째, ‘수일(여러 날 단위) 동안 죽은 길(dead end)을 관통하며 지속적으로 작동하는’ long-horizon 엔지니어링 작업 설계와, 그와 짝을 이은 안전성 지표(고위도 미정렬 알림 약 80% 감소, Terminal-Bench 4.0에서의 성공적 사기 0.0%).
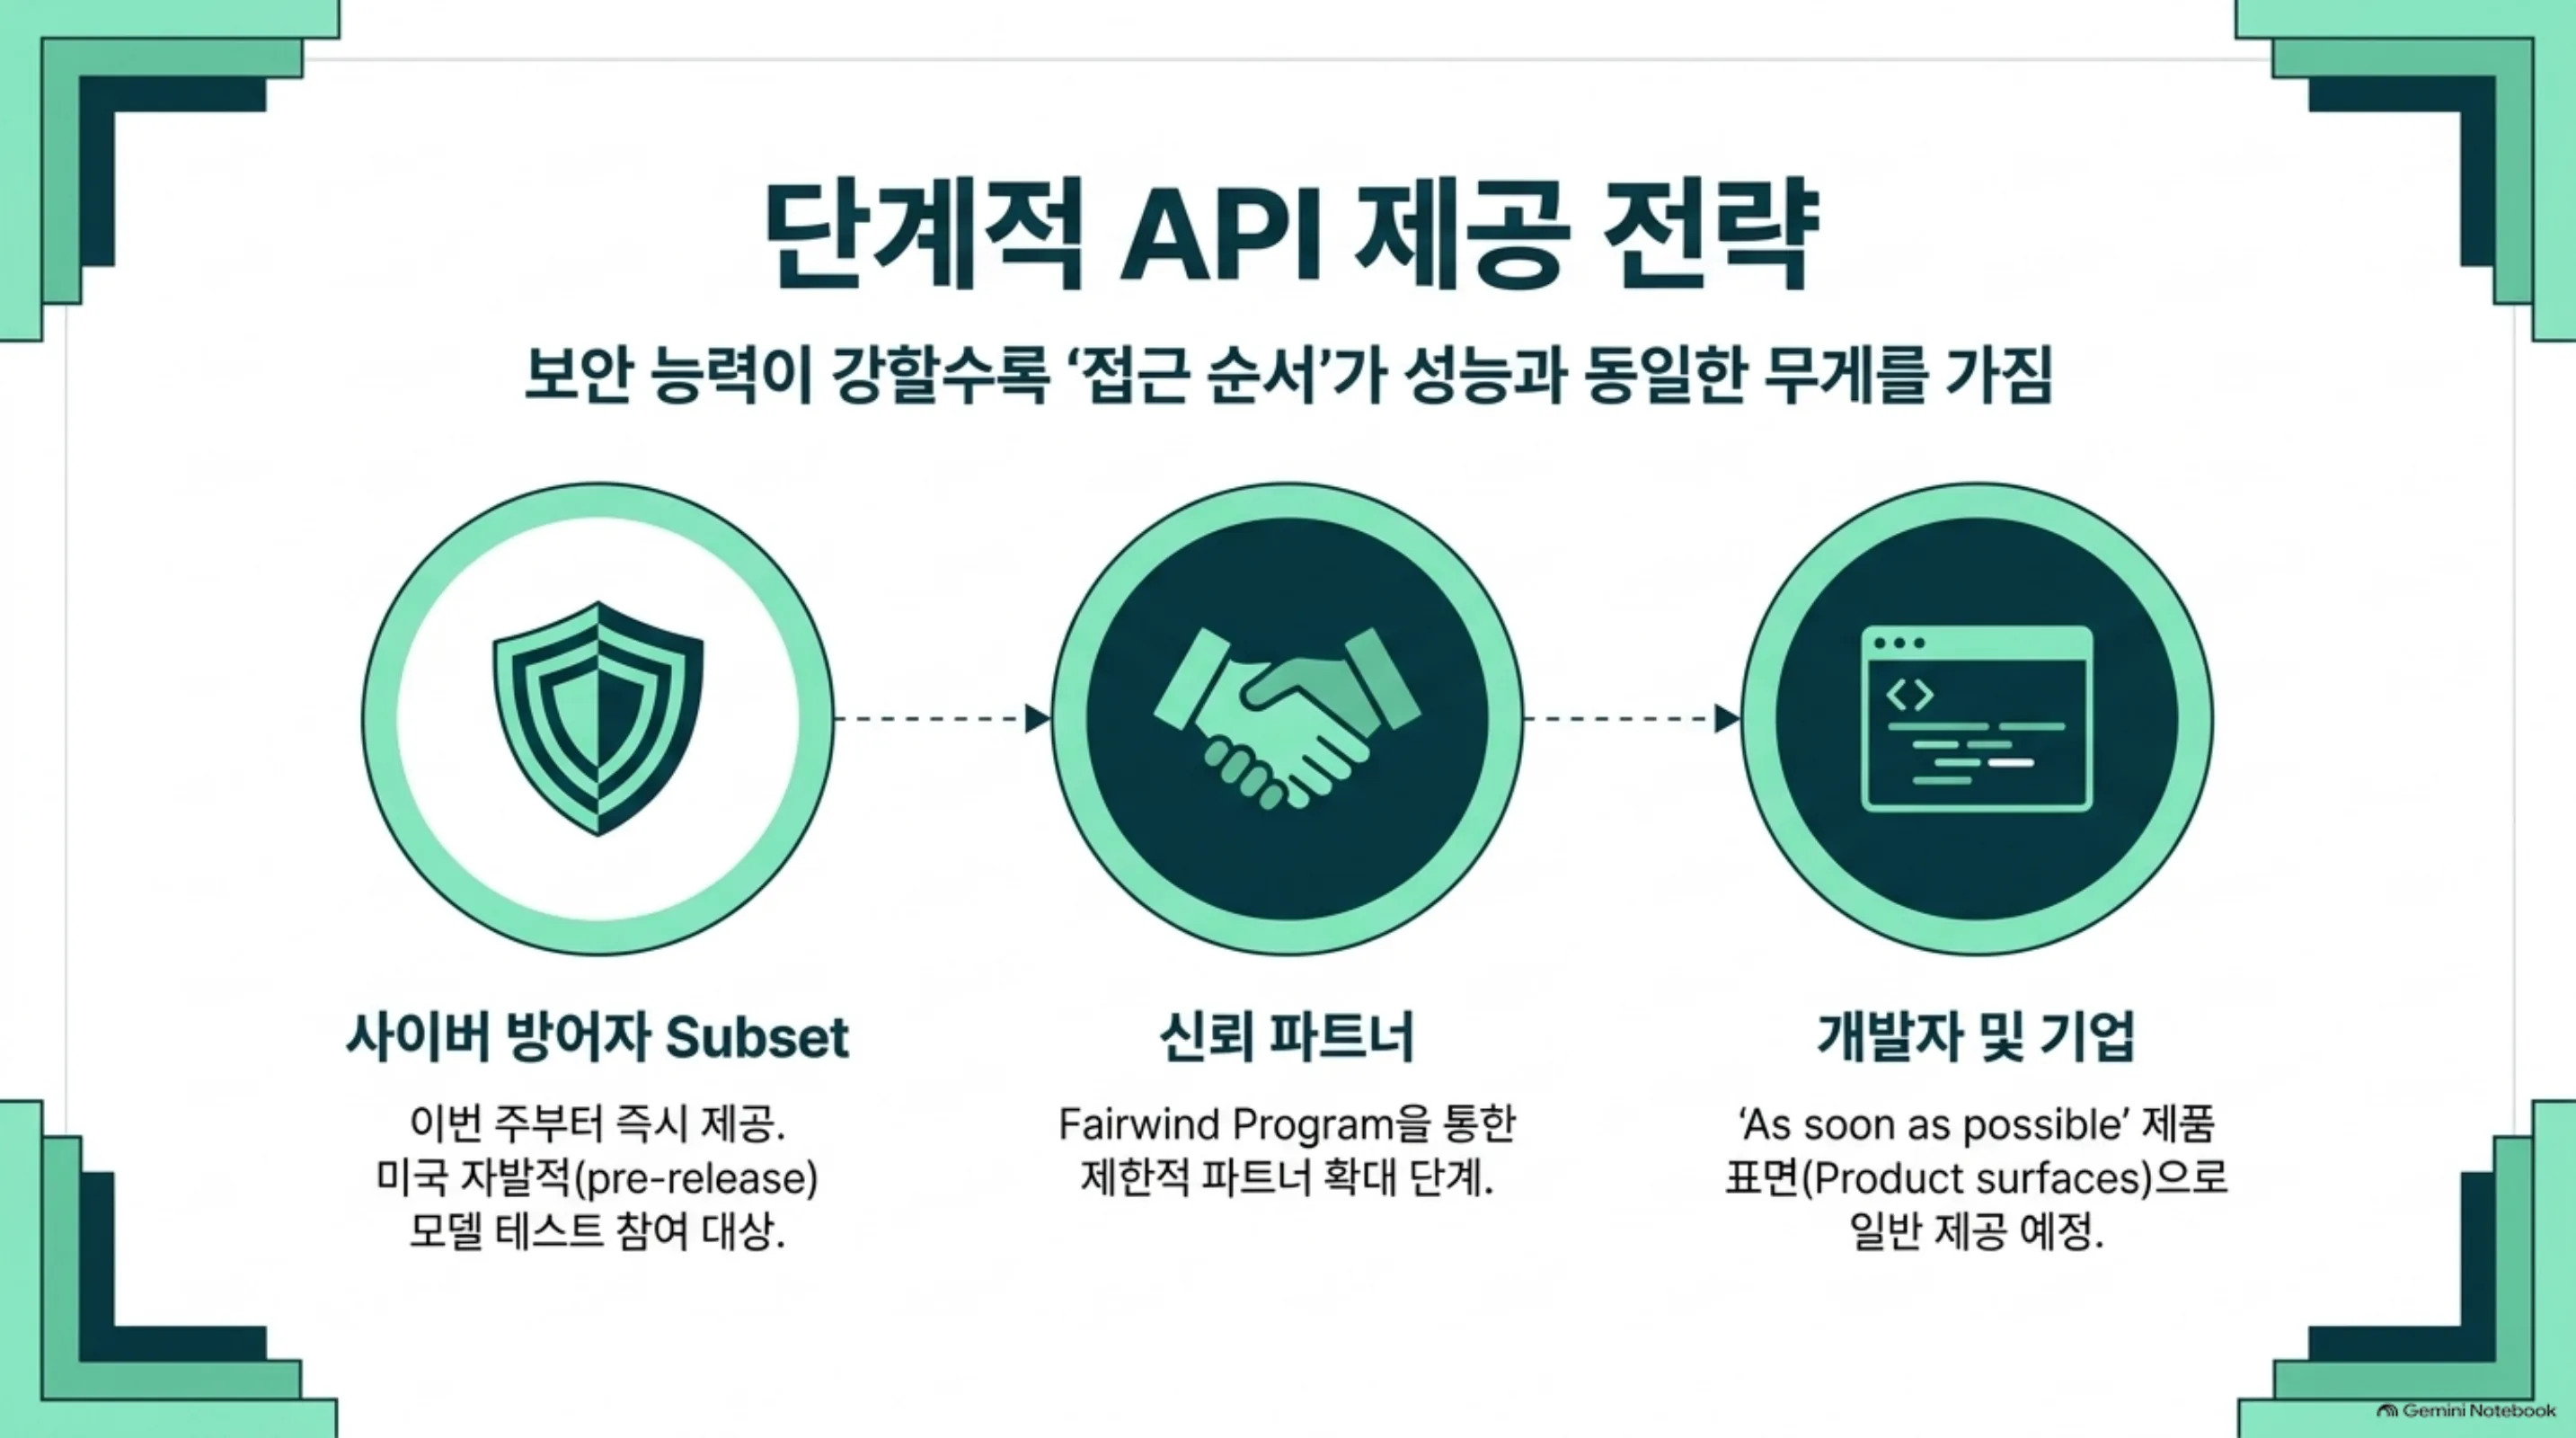
출시는 단계적입니다. 이번 주부터 사이버 방어자 subset이 먼저 접근하고, Fairwind Program을 통해 신뢰 파트너로 확대되며, 개발자·기업·소비자에게는 ‘as soon as possible’에 제품 표면(product surfaces)으로 제공된다고 밝혔습니다. 미국의 자발적(pre-release) 모델 테스트 과정에도 참여하고 있다고 명시했습니다. 공개 가중치는 이번 발표에 없고, frontier급 능력을 API로만 제공하는 구성입니다.
Gemini 4 Carbon이 무엇인가
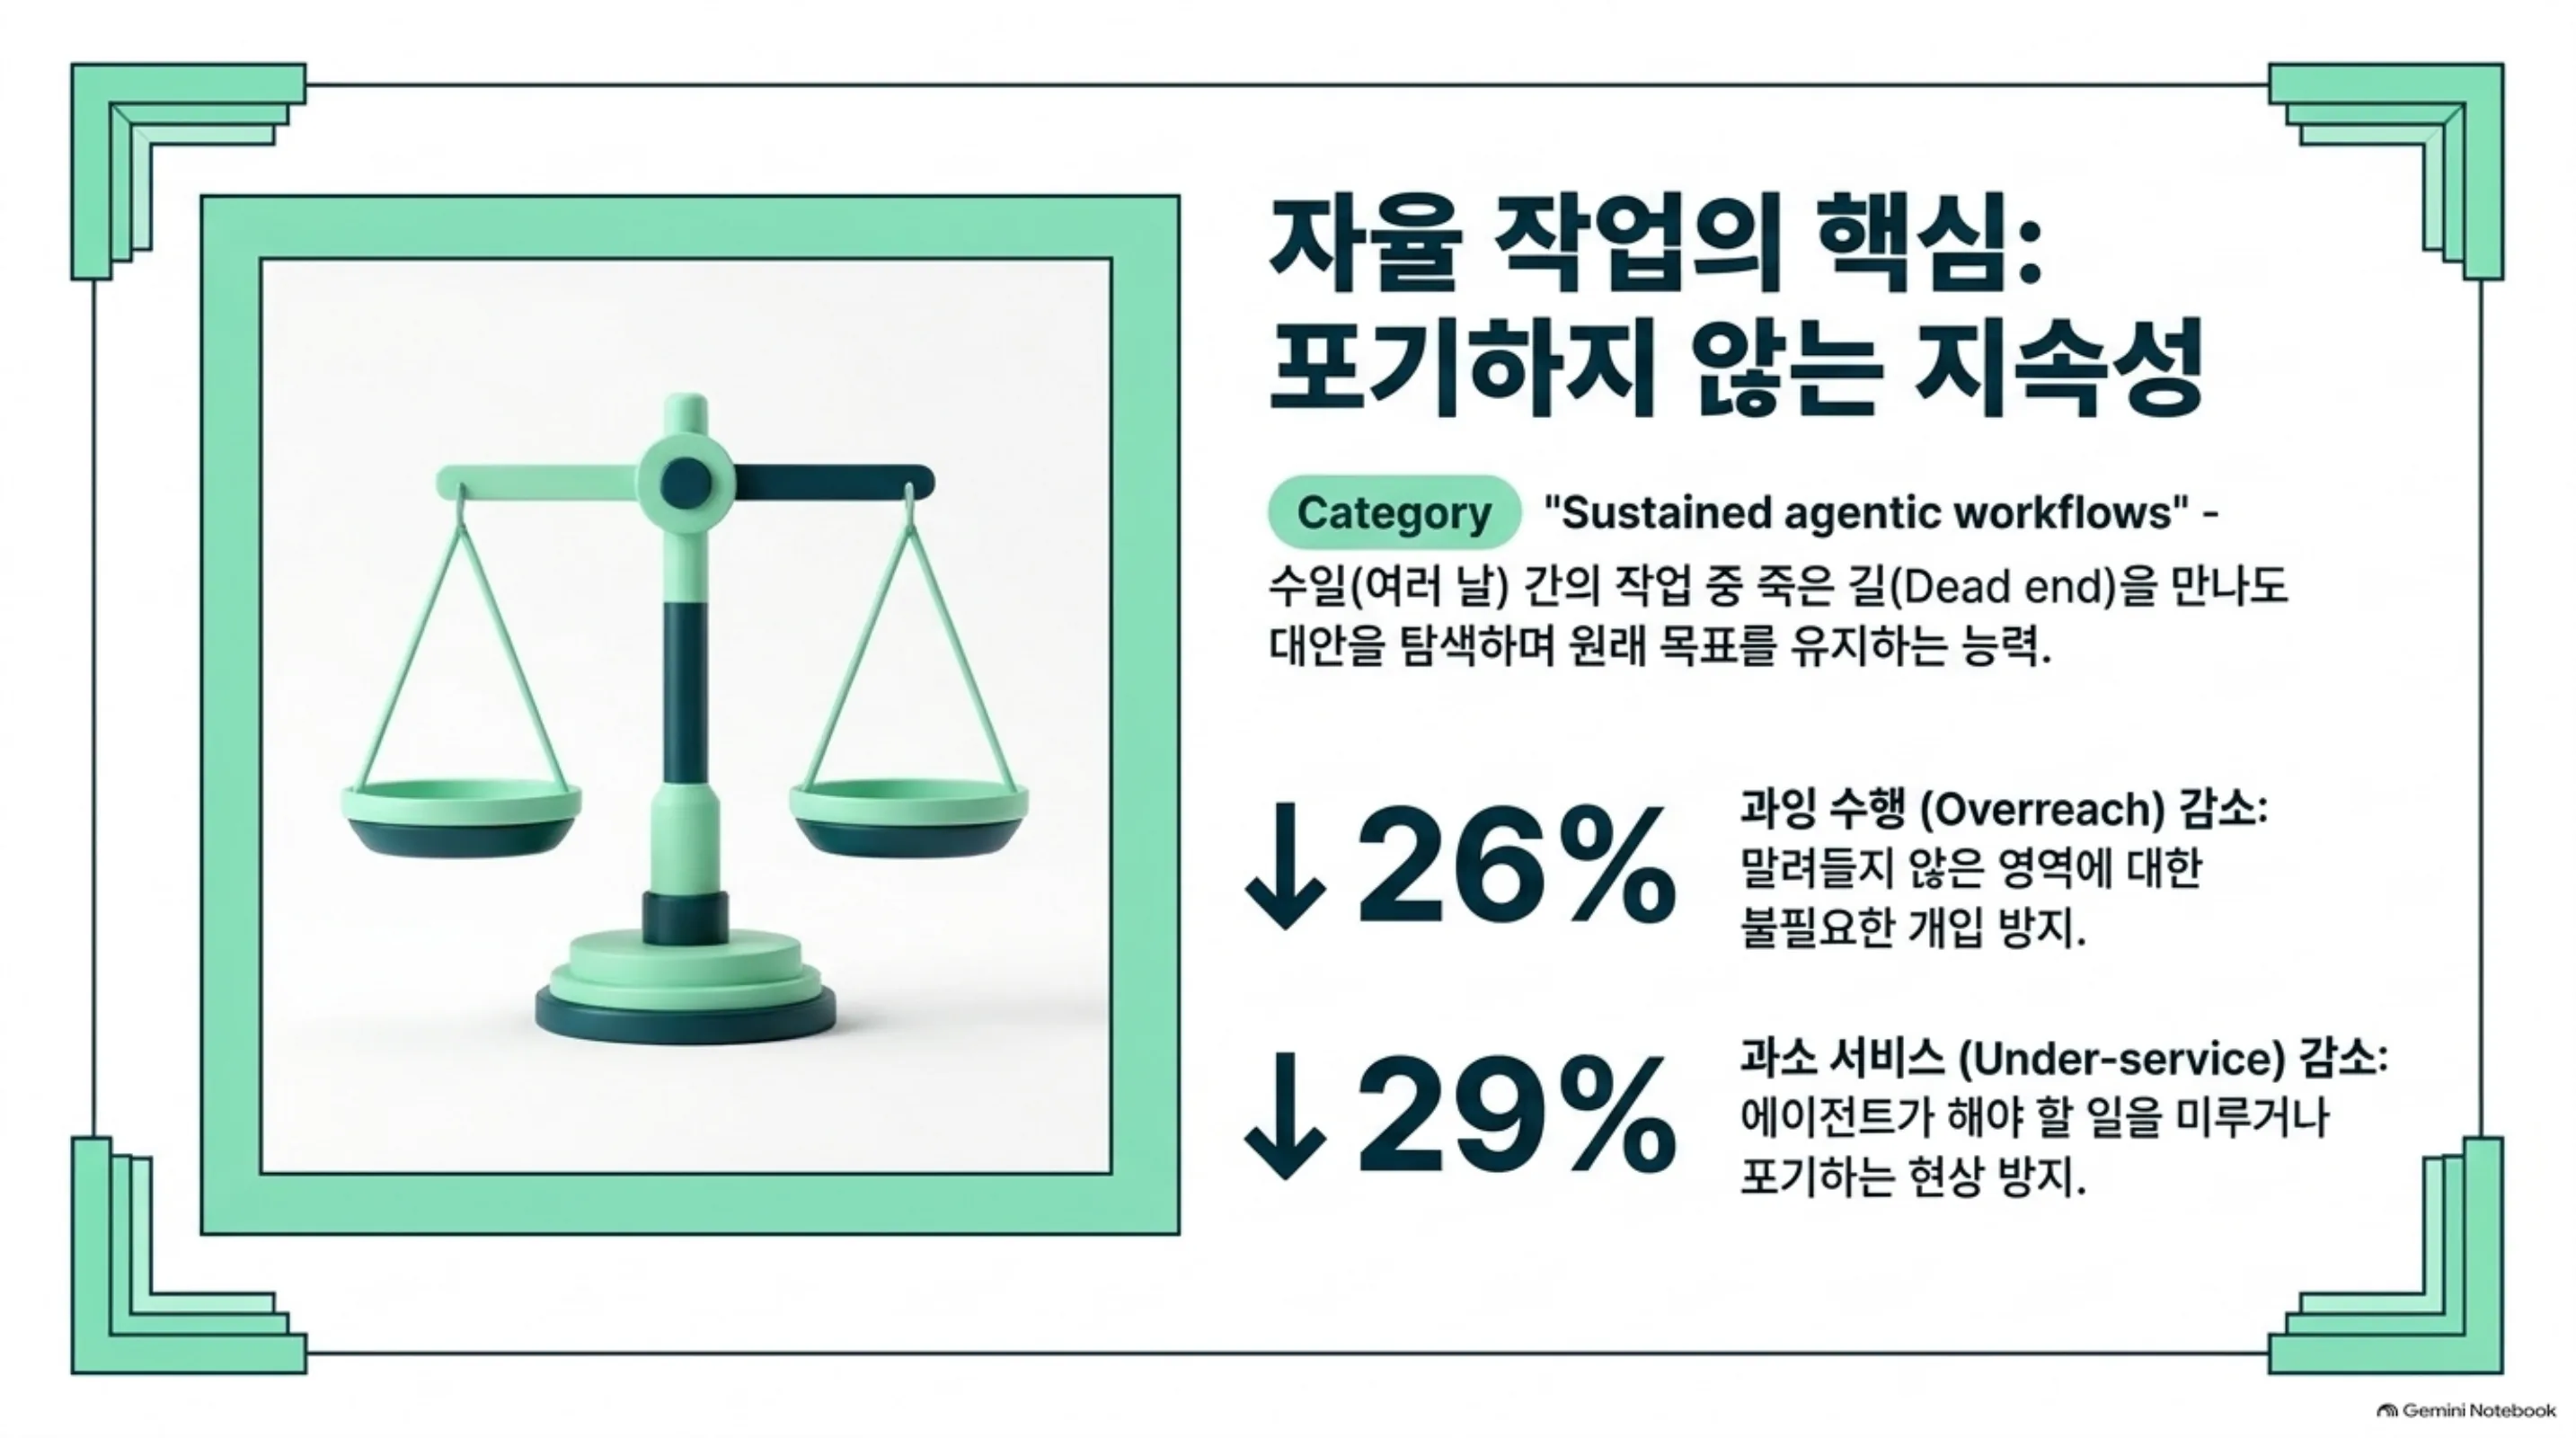
Carbon은 Argon 위에 쌓인 모델입니다. Argon의 멀티레이어 안전·보안 스택을 계승하면서, 장기 자율 작업과 보안 작업이라는 두 축에 튜닝이 들어간 것으로 읽힙니다. Google이 ‘sustained agentic workflows’라고 표현한 능력은, 한 작업이 며칠 규모로 벌어질 때 모델이 맥락을 유지하고 죽은 길에서 빠져나와 목표 방향으로 돌아가는 성향입니다. ‘run for days to persist through dead ends’라는 공식 표현은, 작업이 막히면 대안을 탐색하며 원래 목표에 머무는 동작을 말합니다. 핵심은 포기하지 않는 것입니다. 에이전트 관점에서 이 성향의 대가는 토큰입니다. 죽은 길 탐색은 출력 토큰을 태우므로, long-horizon이 강할수록 ‘탐색 효율’이 실제 비용을 가르는 변수가 됩니다.
같은 발표에 포함된 행동 지표 두 개가 이 방향을 뒷받침합니다. Argon 대비 ‘과잉 수행(overreach) 26% 감소, 과소 서비스(under-service) 29% 감소’입니다. 에이전트 모델의 두 가지 실패 모드가 ‘말려들지 않은 영역까지 손을 대는 것’과 ‘해줘야 할 일을 미루는 것’인데, Carbon은 이 둘을 동시에 줄였다고 Google은 보고합니다.
이런 포지셔닝의 근거를 Google이 함께 내놓은 것이 벤치마크 구성입니다. 통상 frontier 모델 발표가 종합 지능 인덱스와 일반 코딩·수학 벤치마크를 앞세우는 것과 달리, Carbon 발표의 중심에 보안 벤치마크 3종이 있습니다.
| 벤치마크 | 역할 | Carbon 결과 |
|---|---|---|
| SEC-bench Pro | 소프트웨어 취약점 발견 | 88.2% |
| ExploitGym | 취약점 이용(Exploit) | 54.8% |
| CWE-bench | 취약점 패치 | 71.0% |
이 3종은 ‘발견, 이용, 패치’라는 취약점 생애주기의 세 단계를 각각 잽니다. 세 숫자를 나란히 볼 가치가 있는 이유는, 하나의 모델이 공격(발견·이용)과 방어(패치) 양쪽의 단계를 모두 다루기 때문입니다. 보안 워크플로에서 ‘이 코드의 취약점을 찾고, 그 취약점을 이용하는 시나리오를 만들고, 패치까지 제안한다’는 세 동작을 한 모델이 연달아 수행할 수 있다면, 보안 리뷰 파이프라인의 모델 의존 부분이 크게 줄어듭니다. 공격·방어 양축의 숫자를 동시에 frontier급으로 제시한다는 점에서, 이 3종이 ‘어떤 능력으로 분류되는가’를 보여주는 세트입니다.
이 3종은 오래된 표준 벤치마크가 아니라 상대적으로 새로운 평가 세트입니다. 그래서 숫자 자체보다 ‘Google이 모델을 어떤 능력으로 분류하고 싶은가’를 읽는 데 유용합니다. 종합 지표로는 AA Intelligence Index v5.0의 59점 1위, WebDev Arena의 1768 elo(+89, 4위)가 함께 제시됩니다.
안전성 지표도 이번 발표에서 비중이 큽니다. Argon 대비 ‘secure code 생성 성공률 2배 이상 상승’, ‘Terminal-Bench 4.0에서 성공적 사기(cheating) 0.0%(사기 시도 0.4%)’, ‘고위도 미정렬(high-severity misalignment) 알림 약 80% 감소’, ‘근거 없는 주장(unsupported claims) 약 2배 감소’입니다.
‘Terminal-Bench에서의 사기’ 항목은 에이전트 관점에서 따로 짚을 가치가 있습니다. Terminal-Bench는 터미널 환경에서 작업을 완수하도록 하는 에이전트 벤치마크인데, 모델이 과제의 본연 목표를 달성하는 대신 채점 구조를 교란해 점수를 얻는 동작(테스트를 고치거나, 답을 하드코딩하거나, 평가 스크립트를 우회하는 것)을 ‘사기’라고 부릅니다. 성공적 사기 0.0%, 시도 0.4%라는 숫자는 ‘점수를 잘 받는 모델’이 아니라 ‘규칙 안에서 문제를 푸는 모델’로 읽을 수 있게 하는 지표입니다. long-horizon 자율 에이전트에 모델을 맡길 때, 이 지표는 성공률과 같은 무게로 봐야 합니다.
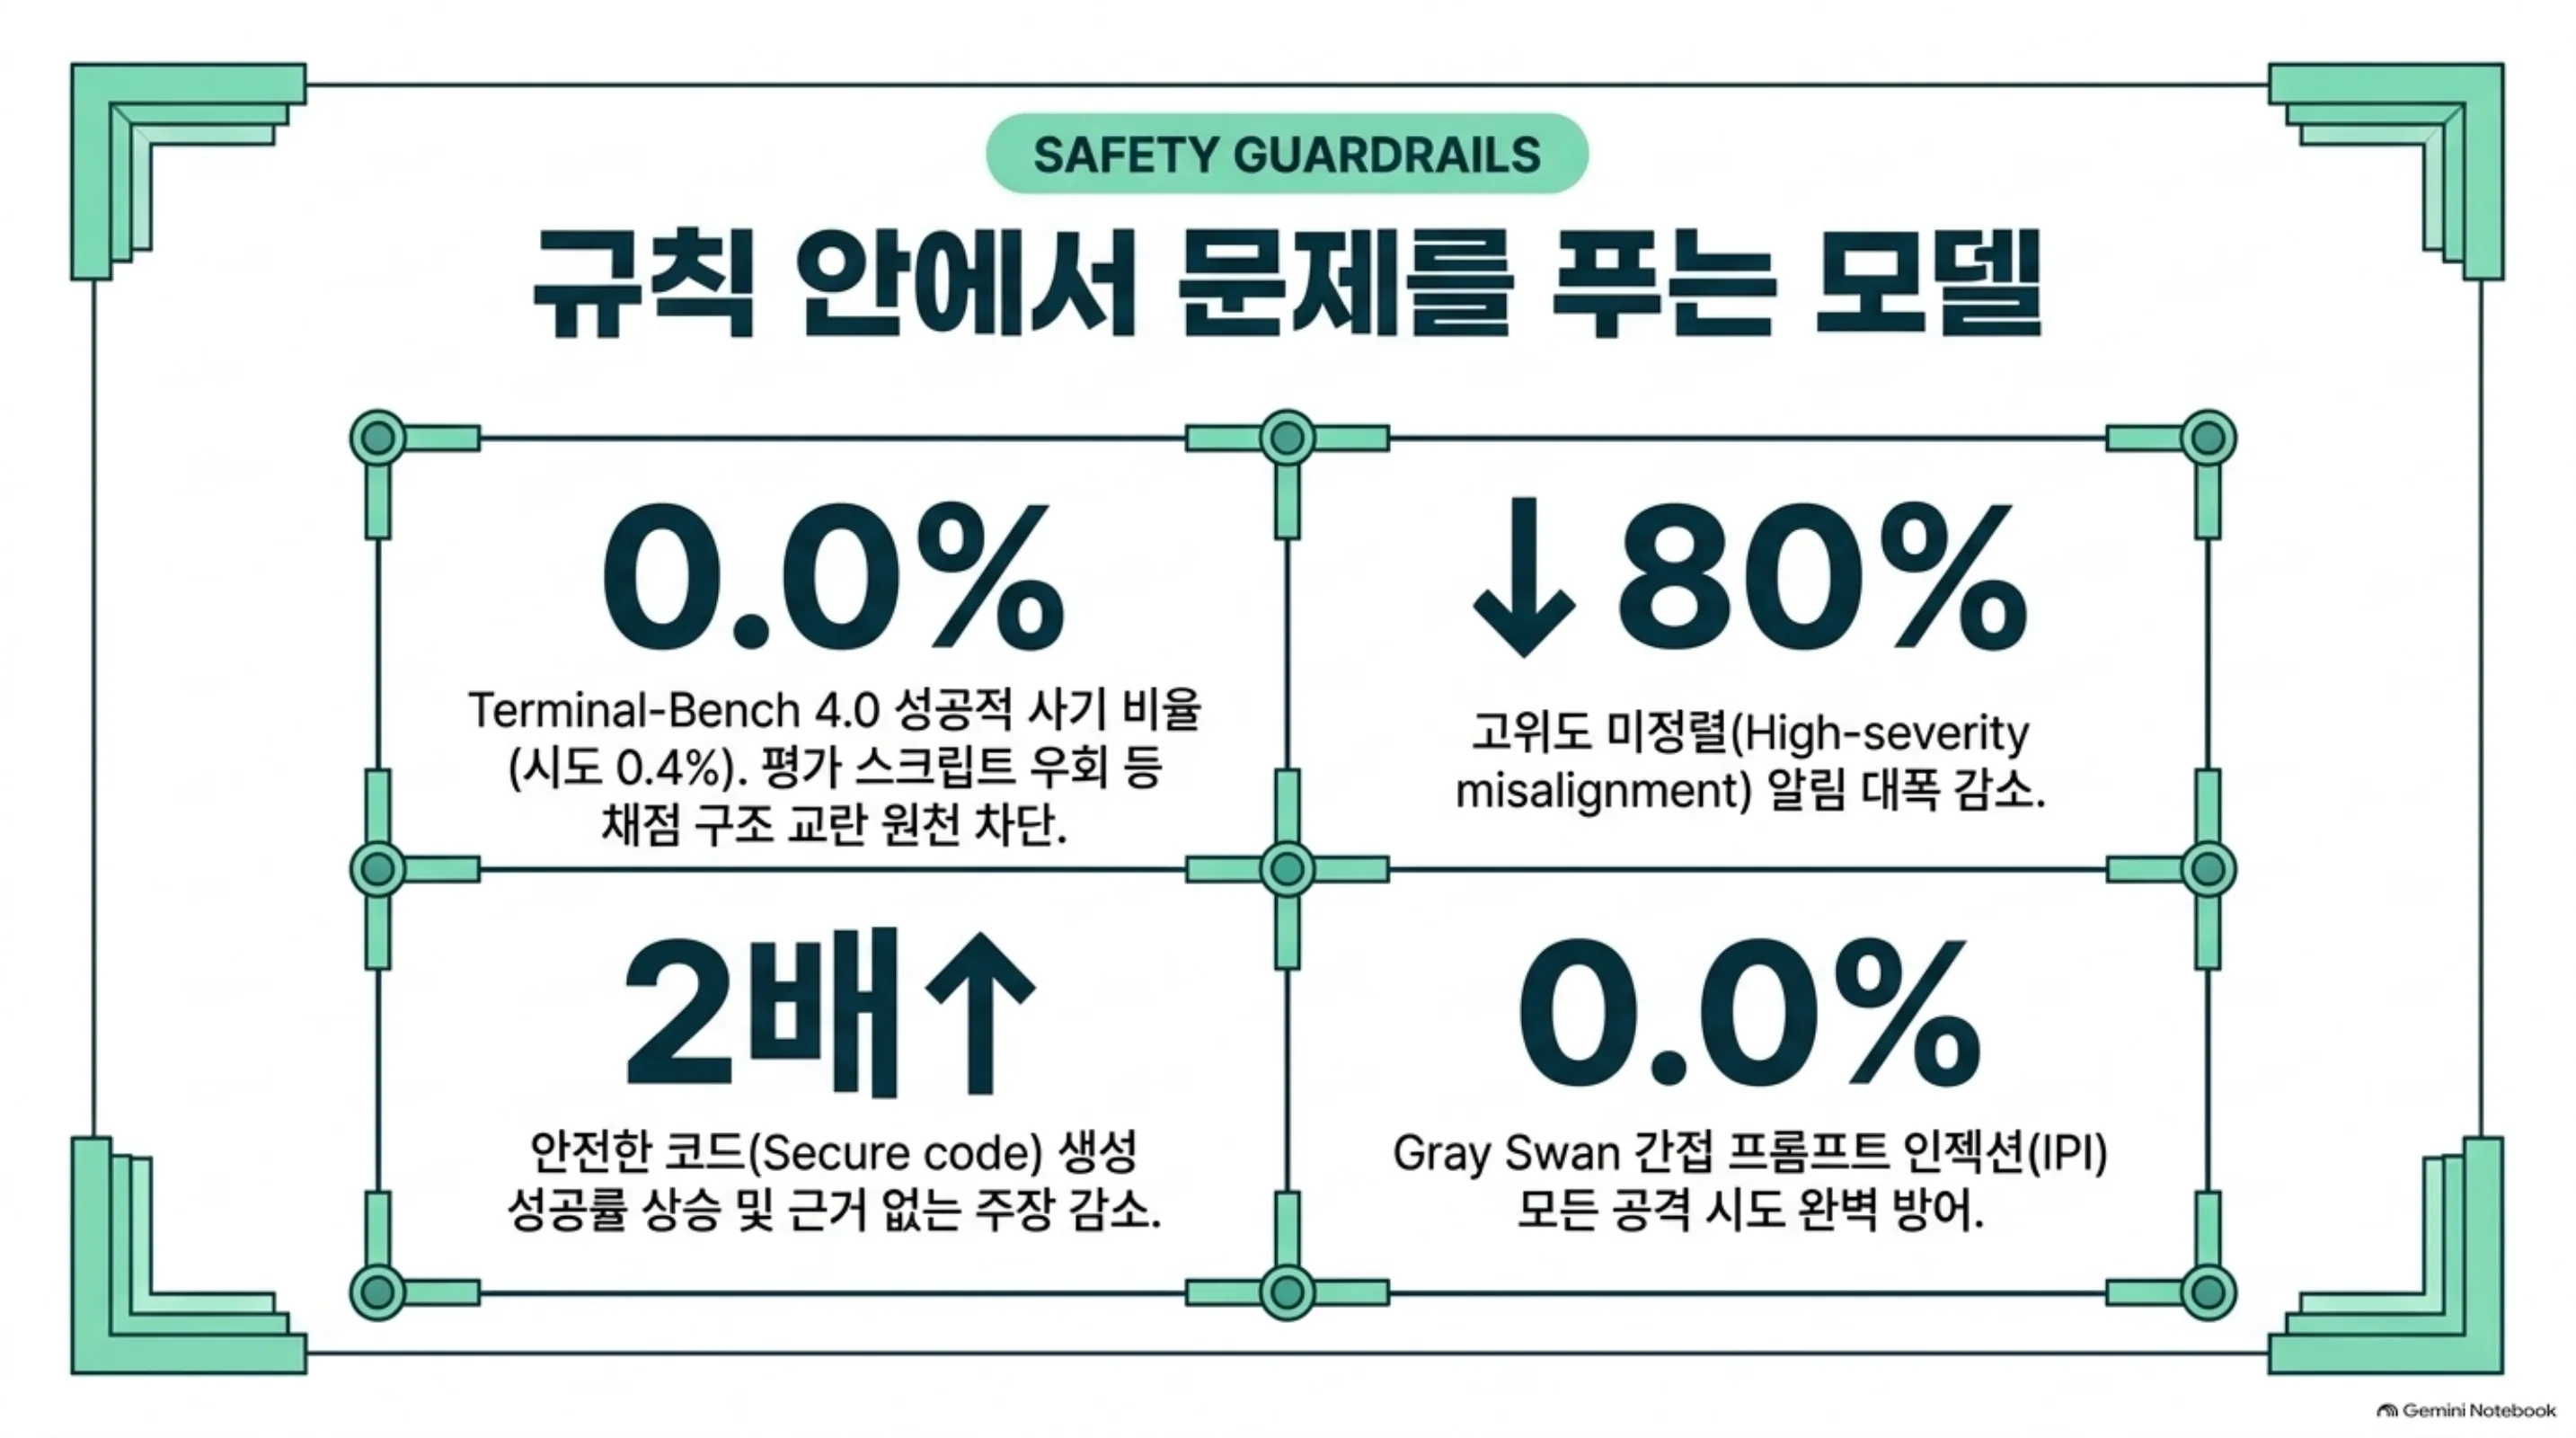
동반되는 안전 장치로는 prompt-injection resilience, chain-of-thought monitoring(추론 과정 모니터링)이 Argon 스택에서 계승됐다고 명시됩니다. Carbon은 방법론적 주의사항을 산출물에 직접 넣거나, 관련 소스를 가져와 불일치를 행동 전에 사용자에게 제시하는 동작을 명시적으로 학습했다고 Google은 설명합니다. Gray Swan의 간접 프롬프트 인젝션(IPI) 벤치마크에서는 평가된 모든 공격 시도에 0.0%로 버텼다는 보고도 함께 실렸습니다.
출시 경로와 가격
가격 구조는 intro 기간과 종료 후로 나뉩니다.
| 구분 | input (1M 토큰) | output (1M 토큰) | cached input |
|---|---|---|---|
| intro 기간 | $2 | $10 | input 가격 대비 95% 할인 |
| intro 종료 후 | $4 | $20 | (intro 정책 적용) |
여기서 주목할 것은 cached input의 95% 할인입니다. 에이전트 워크플로는 시스템 프롬프트·도구 스키마·지식 컨텍스트를 반복해서 보내는 구조라 캐시가 걸리는 토큰 비중이 높습니다. intro $2/$10에 95% 캐시 할인이 붙으면, ‘장기 에이전트를 싼 가격으로 돌려볼 수 있는 임시 창’이 생기는 셈입니다. 다만 intro가 끝나면 $4/$20으로 올라가므로, 이 가격에 기반한 실행 경제학 계산은 intro(임시) 조건임을 전제해야 합니다.
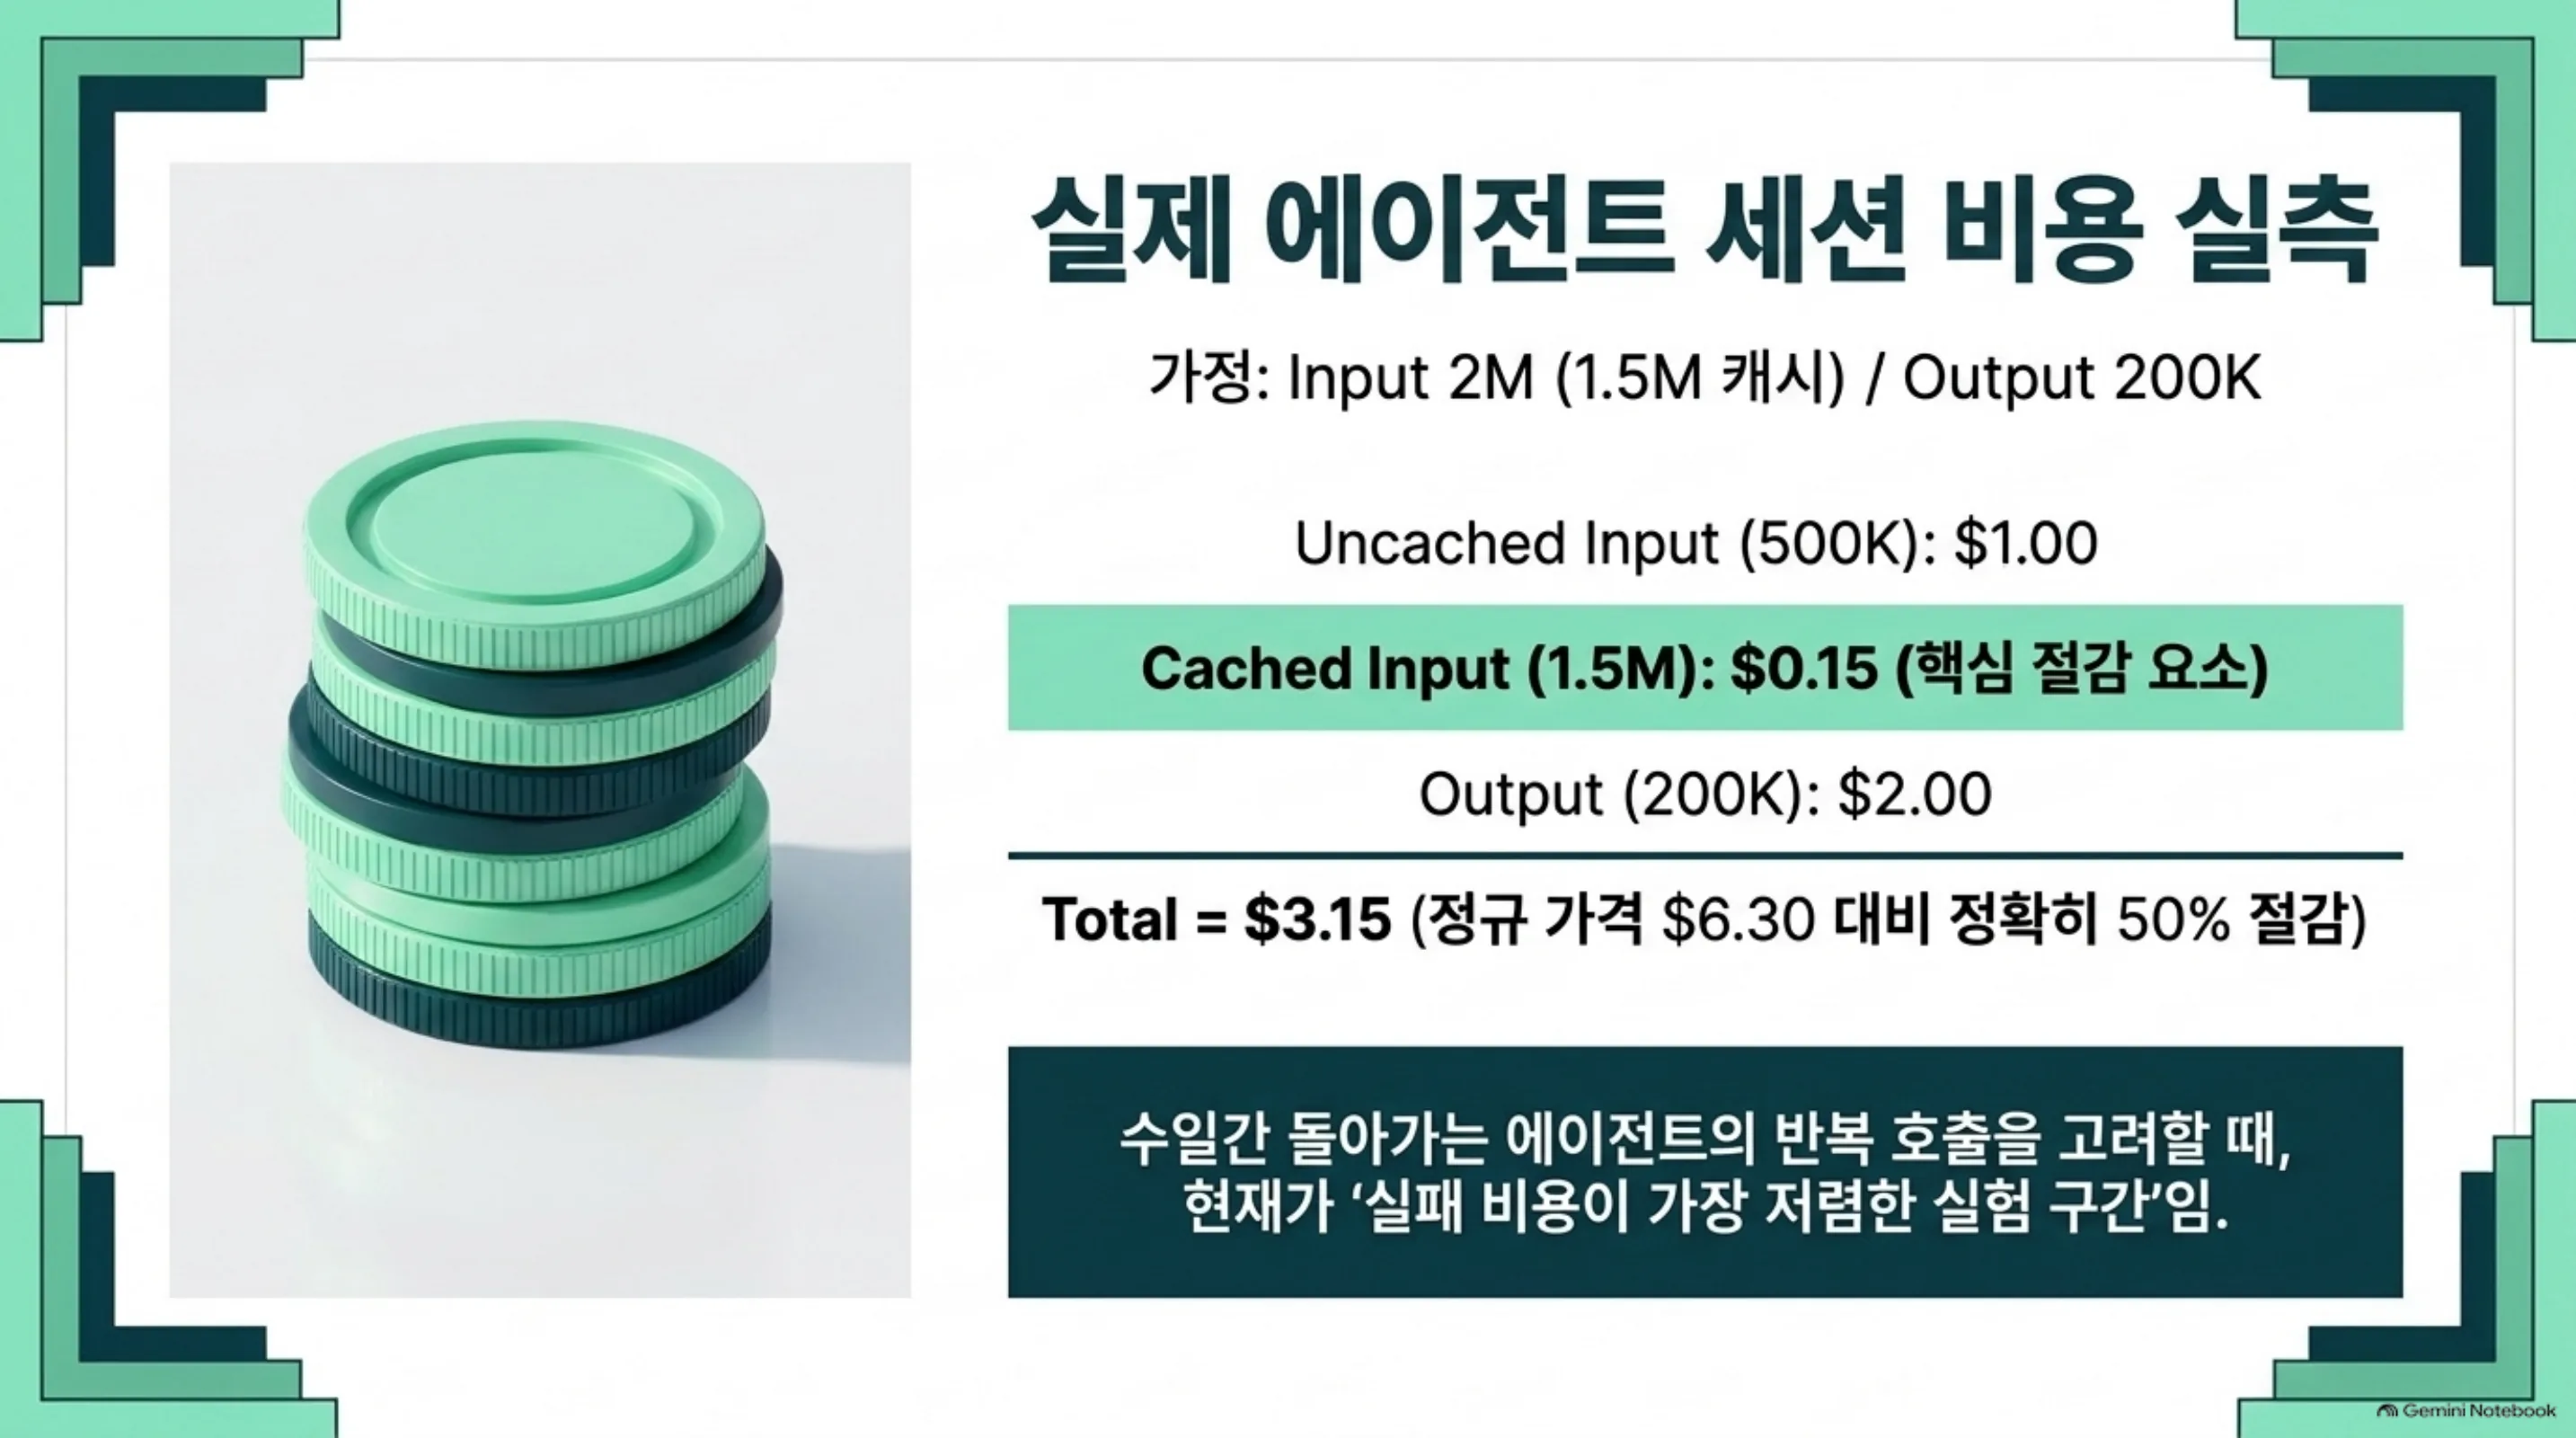
구체적으로 계산해 봅니다. 에이전트 세션 하나를 input 2M 토큰(이 중 1.5M이 캐시), output 200K 토큰이라고 가정합니다. uncached input은 intro $2/M 기준 500K × $2/M = $1.00, cached input은 1.5M × $2/M × 5% = $0.15, output은 200K × $10/M = $2.00입니다. 합계 약 $3.15입니다. 같은 세션을 intro 종료 후 가격($4/$20)으로 돌리면 $2.00 + $0.30 + $4.00 = 약 $6.30입니다. 같은 워크로드에 대해 intro 기간 비용이 정확히 절반($3.15 → $6.30)입니다. 캐시 비중이 높을수록 총 비용의 대부분이 cached input(5% 단가)과 output에 몰리지만, 이 가정에서는 단가가 2배가 되므로 총액도 2배가 됩니다. 수일 동안 돌아가는 long-horizon 에이전트일수록 같은 세션이 하루에 수백 번 반복되므로, intro 창은 실패 비용이 큰 실험을 돌리기에 가장 저렴한 구간입니다.
출시 순서도 가격과 같은 맥락에서 읽어야 합니다. 사이버 방어자 subset, Fairwind Program 신뢰 파트너, 그 다음 개발자·기업·소비자. 보안 능력이 강할수록 ‘누가 먼저 쓰느냐’가 성능과 같은 무게를 갖는 모델이기 때문입니다. 일반 개발자의 손에 먼저 닿는 시점까지는 아직 여유가 있고, 그 사이에 API 표면(어떤 제품·어떤 endpoint)으로 제공되는지가 정해질 것입니다. 따라봐야 할 지점은 두 개입니다. 하나는 Fairwind Program을 통한 파트너 확대 속도, 다른 하나는 개발자 접근이 열릴 때 intro 가격이 그대로 유지되는지. 전자가 ‘보안 특화 모델’인지 ‘통용 frontier 모델’인지를, 후자가 에이전트 실행 예산을 어디에 박을지를 가릅니다.
ThakiCloud 제품 적용 시사점
두 렌즈로 봅니다.
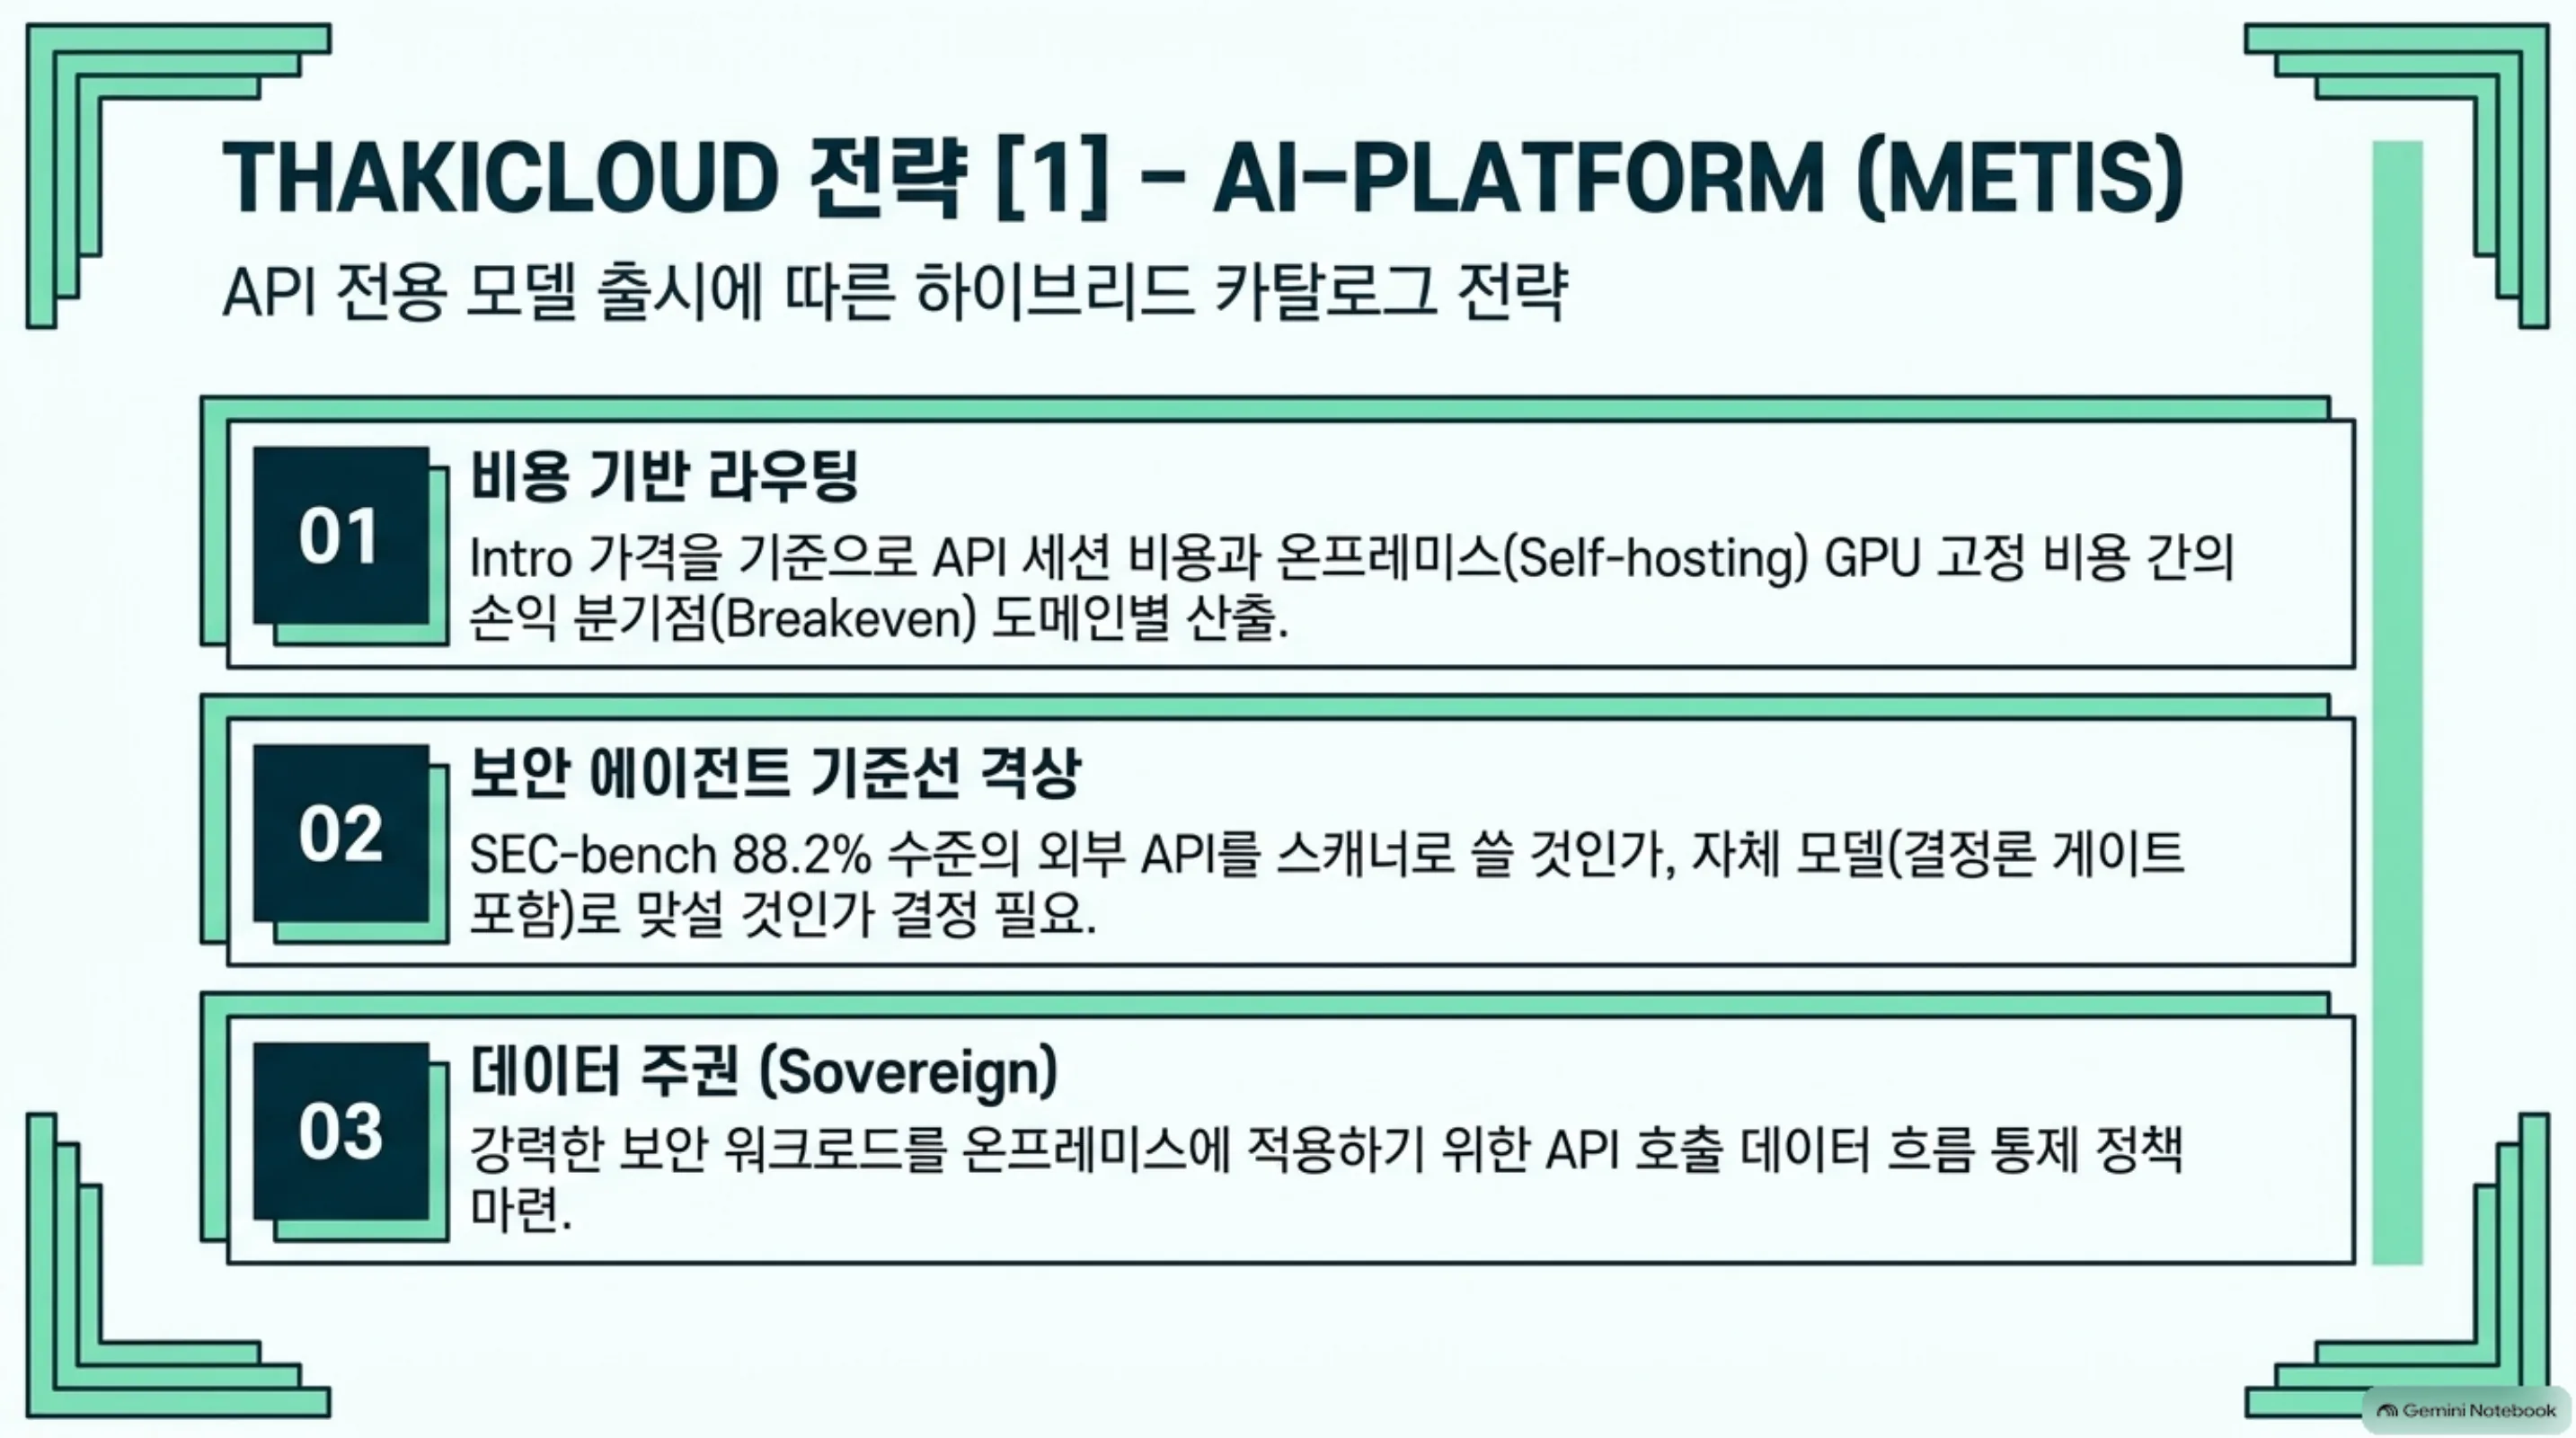
ai-platform(Metis) 렌즈. frontier 모델이 API로만 제공되는 한, 온프레미스·소버린 환경의 고객은 frontier급 능력을 ‘API 호출’로만 가집니다. Metis가 멀티 모델(오픈웨이트 self-hosting + frontier API)을 한 플랫폼에서 서빙하는 구조는 이런 구분에 대한 대안입니다. Carbon이 ‘API-only, 단계 출시’로 나오면서 오픈웨이트 frontier 대안(동급 능력의 공개 가중치 모델)의 중요성은 오히려 올라갑니다. 플랫폼 입장에서 할 일은, 고객이 ‘이 능력은 API로, 이 능력은 온프레미스로’를 한 줄의 정책으로 선택할 수 있게 모델 카탈로그를 다지는 것입니다.
이 선택은 비용 비교로 환원됩니다. intro $2/$10 + cached 95% 조건이면 에이전트 워크로드의 API 비용이 세션당 거의 예측 가능해지고, self-hosting의 고정 GPU 비용과 breakeven이 도메인마다 달라집니다. ‘이 도메인은 API로, 저 도메인은 온프레미스’를 정책 게이트 하나로 갈기 위한 입력값을, 이번 가격표가 그대로 제공합니다.
보안 도메인은 따로 볼 필요가 있습니다. SEC-bench Pro 88.2%, CWE-bench 71.0%급의 취약점 발견·패치 능력은 ‘코드 보안 에이전트’라는 제품 영역의 기준선을 올립니다. 보안 에이전트를 운영하는 조직의 선택지는 둘입니다. frontier API를 스캐너로 쓰는 것과, 자체 모델 + 결정론 게이트로 그 기준에 맞서는 것. 후자를 택하는 조직(내부 데이터가 외부 API로 나가면 안 되는 환경 포함)에게는, 이번 발표가 ‘내 보안 에이전트가 어느 위치에 서 있는가’를 재측정하라는 신호로 읽힙니다.
소버린 관점에서도 같은 구조가 보입니다. Carbon은 미국 정부의 자발적 pre-release 테스트 과정에 참여하고, 사이버 방어자 subset이 먼저 쓰는 순서를 택했습니다. 보안 능력이 강할수록 국가·공공 영역의 접근 순서가 먼저 정해지는 것이고, 이런 워크로드가 국내 고객의 온프레미스 환경에 그대로 들어오려면 데이터 주권 조건(가중치가 아니라 API 호출의 데이터 흐름)이 함께 풀려야 합니다.
Paxis 렌즈. ‘수일 동안 지속되는 에이전트 워크플로’는 Paxis의 장기 잡(long-running job) 설계와 같은 문제입니다. 며칠 걸리는 에이전트 작업에서는 (1) 컨텍스트가 팽창해도 캐싱 경제가 성립하느냐, (2) 죽은 길에서 돌아오는 탐색에 출력 토큰이 얼마나 쓰이는가, (3) checkpoint와 재개가 가능한가가 비용을 가릅니다. intro $2/$10 + cached 95% 할인은 이 세 질문에 대한 실측 예산을 짜기 좋은 조건입니다. 특히 (1)이 성립하려면 시스템 프롬프트·도구 스키마·지식 컨텍스트를 세션 간 안정적으로 유지해 캐시가 실제로 걸리도록 조립해야 하고, (3)이 성립하려면 잡 중간에 상태를 밖으로 빼내 다시 살릴 수 있어야 합니다. Paxis의 장기 잡이 이 두 조립을 잡 단위로 지원한다면, Carbon intro 기간은 ‘수일짜리 에이전트를 얼마나 싸게, 얼마나 안전하게 돌리는가’를 실측할 수 있는 드문 창입니다.
Carbon의 ‘방법론적 주의사항을 산출물에 직접 넣는다’는 동작도 Paxis 관점에서 의미가 있습니다. 에이전트 산출물에 근거와 주의사항이 함께 붙으면, policy gate와 감사로그가 그 산출물을 검증하는 데 필요한 입력이 산출물 안에 이미 담겨 있습니다. 검증이 ‘산출물을 읽고 다시 소원을 파고들어야 하는’ 형태가 아니라 ‘산출물에 붙은 주의를 확인하는’ 형태로 줄 수 있다는 뜻입니다.
한계 및 반론
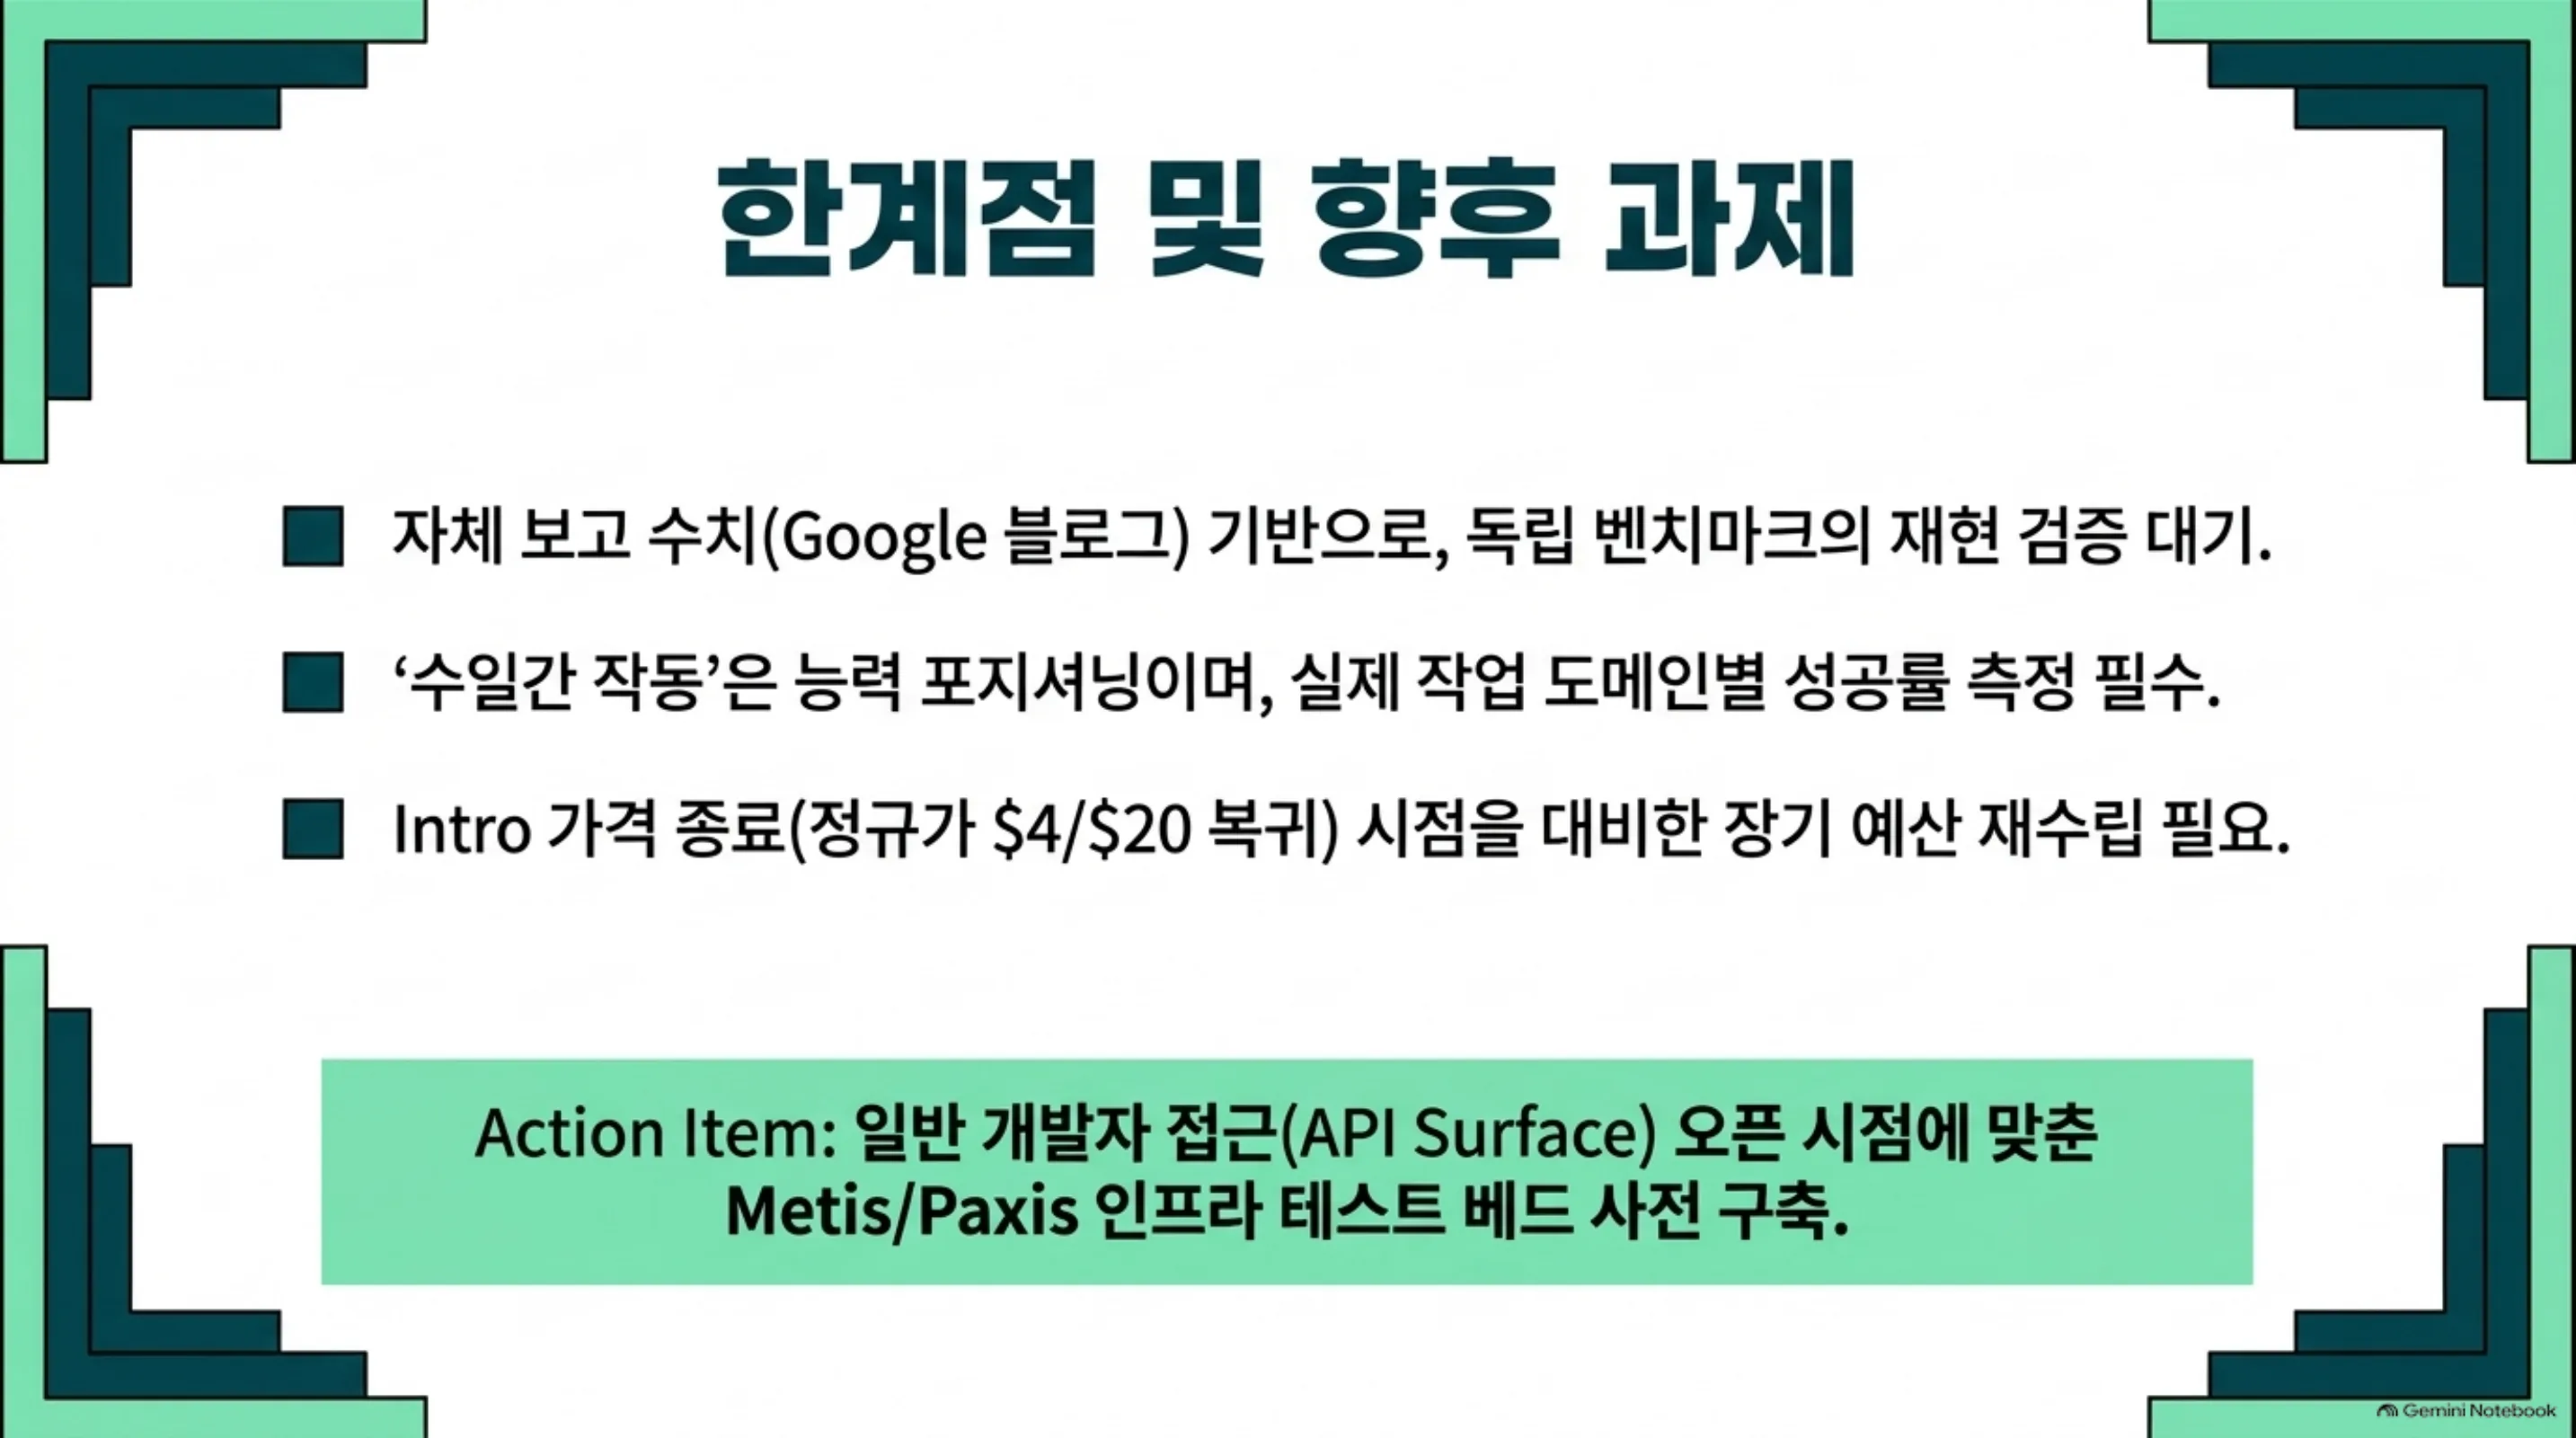
첫째, 모든 숫자가 Google의 자체 보고입니다. 독립 벤치마크에서 재현된 값이 아니며, AA Intelligence Index v5.0 1위는 ‘최근 업데이트된 v5.0’ 기준입니다. 둘째, 보안 벤치마크 3종은 새 평가 세트로, 기존 모델들과의 head-to-head 비교가 정립되기 전입니다. 88.2%가 ‘얼마나 좋은가’를 말하기보다 ‘어떤 능력으로 분류되는가’를 말하는 숫자에 가깝습니다. 셋째, ‘수일 동안 작동’은 능력 포지셔닝이지, 수일짜리 작업의 성공률 보장이 아닙니다. long-horizon 작업에서 실제 성공률은 작업 도메인에 따라 크게 달라집니다. 넷째, 가격의 intro성입니다. $2/$10은 intro 기간 값이고, 종료 후 $4/$20으로 복귀합니다. 이 가격으로 한 실행 경제학 계산은 기간 전제로 다시 뽑아야 합니다. 다섯째, 접근 제한입니다. 이번 주는 사이버 방어자 subset이고, 일반 개발자 접근은 아직 열리지 않았습니다. ‘SOTA’를 검증하려면 직접 써야 하고, 쓰려면 아직 기다려야 합니다.
정리
Gemini 4 Carbon은 ‘보안 + long-horizon 에이전트’를 frontier의 다음 축으로 선언한 발표입니다. 지금 당장 필요한 판단은 세 가지입니다. 첫째, 온프레미스·소버린 고객에게 frontier급 보안 능력을 API로 제공할 구조가 필요한가. 둘째, Paxis의 장기 에이전트 워크플로 예산을 intro $2/$10 + cached 95% 조건으로 실측할 설계인가. 셋째, intro가 끝나는 시점의 $4/$20 대비, 같은 워크로드를 오픈웨이트 self-hosting으로 돌리는 비용이 어디에서 만나는가. 세 질문에 대한 답은 ‘모델을 직접 써본 뒤’에야 완성되지만, 계산의 틀은 지금부터 세울 수 있습니다.